 最新模型
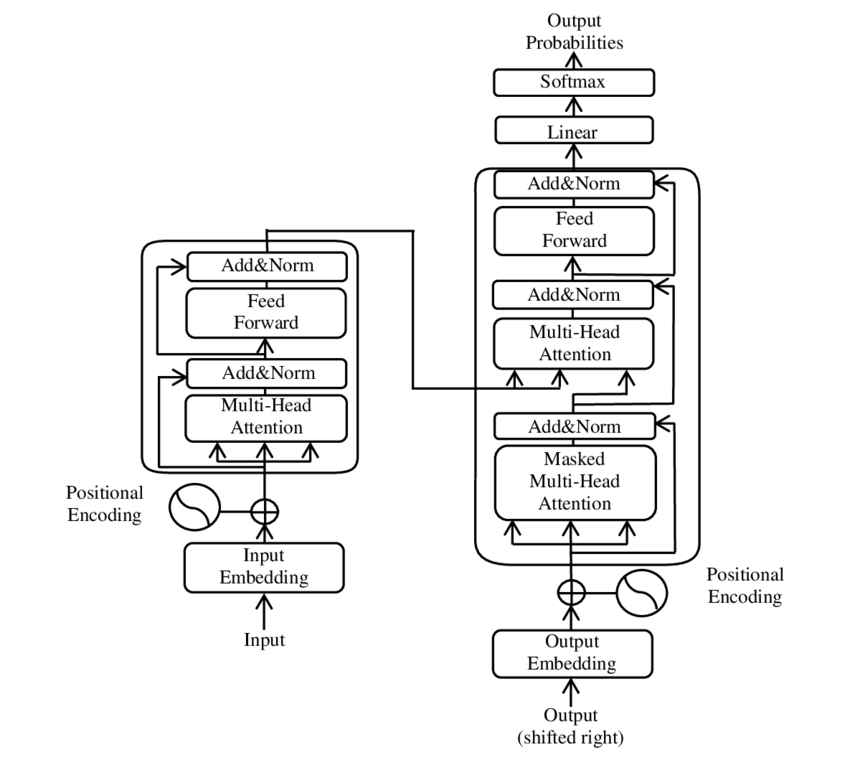
Intern-S2-Mobius 將 FFN 記憶全域共享,35B 模型報告近 4 倍端到端推論加速
Intern-S2-Mobius 把傳統 Transformer 各層綁定的知識儲存與注意力推理拆開,讓多個 Reasoner 反覆查詢同一組全域 Memory。開放權重可由 LMDeploy、vLLM 或 Transformers 載入,但近 4 倍加速仍是官方特定評測結果。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
最新模型
Intern-S2-Mobius 把傳統 Transformer 各層綁定的知識儲存與注意力推理拆開,讓多個 Reasoner 反覆查詢同一組全域 Memory。開放權重可由 LMDeploy、vLLM 或 Transformers 載入,但近 4 倍加速仍是官方特定評測結果。
 代理工具
新版允許在尚未取得 `run_input` 時建立 `UIEventStream`,並讓 `AGUIEventStream` 自行持有 thread 與 run ID。它亦修正 Temporal 沙箱相容性及備援模型的 tracing 歸屬,減少長時代理流程中的診斷盲點。
 最新模型
Cursor 確認加入 SpaceXAI,雙方將共同改進 Grok Build、Grok Bot、Grok API 與 Cursor。交易把 GPU 基礎設施、程式模型訓練及百萬級開發者入口垂直整合,但尚未公布模型、資料或 API 的遷移時程。
 推論系統
新版加入 Kimi K3 的文字模型、混合 KDA/MLA 注意力、latent MoE 與工具呼叫解析。轉換器直接重排 MXFP4 位元配置,毋須先展開整個 2.8T 模型至 BF16。
 最新模型
Google 將 Gemini 3.7 Flash 推向 API、Antigravity、Android Studio及企業代理平台,並以限時半價切入高流量代理工作負載。首批整合顯示多模態、工具呼叫與跨 API 格式已可用,但推理參數和成本資料仍有遷移陷阱。
 生成式 AI 工具
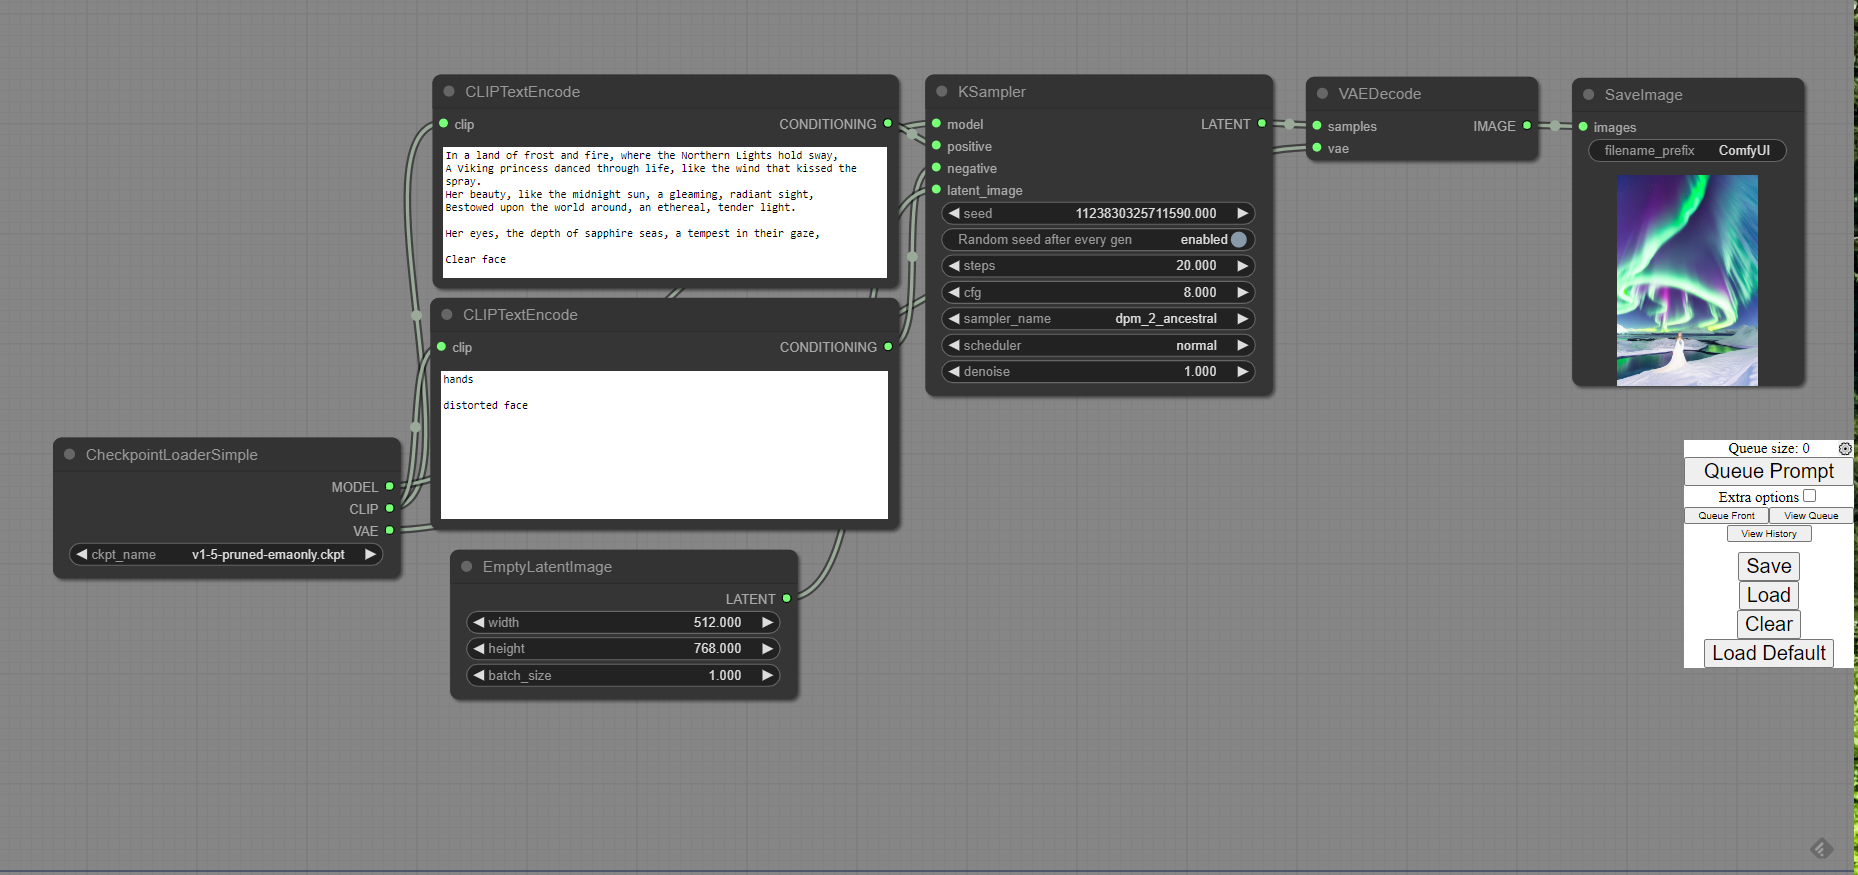
ComfyUI 0.33.1 把 MiniMax Music 3 的模型載入及推理節點納入核心,並加入可供後端使用的 CUDA Graph 支援。版本亦修正固定 VRAM 配置無法執行 Music 3,以及部分 MiniMax 權重 QKV 版型辨識問題。
 推論系統
vToken 在既有 PagedAttention 上加入邏輯 token 表與非同步壓縮,讓逐 token 淘汰真正釋放實體區塊。vLLM 原型的 SLA 吞吐最高提高 1.37 倍,但尚未公開程式,也未證明搬移成本適用所有硬體與流量。
 最新模型
Z.ai 表示 GLM-5.3 未重新預訓練,程式與資安能力提升均來自更大規模的後訓練。模型在 CyberGym 報告 84.5%成功率,但權重須待雙重用途風險評估完成才會釋出。
 最新模型
研究團隊從 FineWeb‑Edu 篩出 880 億 token 的 K–5 語料,並從零訓練 0.6B、1.3B 與 5B 模型及同算力對照組。實驗顯示擴大模型、SFT+GRPO 和上下文示例主要喚起已有能力,未明顯突破預訓練知識邊界。
 推論系統
Reduced Matrix Multiplication 不改權重,而是按當前 activation 的欄範數,只計算矩陣乘法中分數最高的共享維度。A100 測試顯示收益隨序列增長,但短上下文的選擇與 kernel 啟動成本幾乎抵消節省。
 AI 基礎設施
OpScale 不再複製整個模型,而是按流量與序列長度,只擴充當下成為瓶頸的 attention、MLP 等算子。作者在 A100 與 GB200 叢集重播 92.9 萬個請求,最高以少 36.3% GPU 達到相同延遲目標,但原型程式尚未公開。
 AI 安全
RAGSieve 不需要可信語料庫或預先標註的毒化樣本,而是分別比較查詢排名尾端與文件的局部語意鄰域。開源實驗涵蓋三個問答集、三款檢索器及六種攻擊,但單篇流暢毒文與已污染的檢索尾端仍可能繞過偵測。