 推論系統
Daedalus-150M 以卷積取代三分之二注意力層,2K 上下文 CPU 解碼加速 1.76 倍
Daedalus-150M 專為單使用者、4-bit CPU 推論設計,讓多數網路層不必反覆讀取持續增長的 KV cache。初步結果顯示速度優勢會隨上下文增加,但模型只有 2K 上限,效能數字也仍待跨硬體獨立重現。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
推論系統
Daedalus-150M 專為單使用者、4-bit CPU 推論設計,讓多數網路層不必反覆讀取持續增長的 KV cache。初步結果顯示速度優勢會隨上下文增加,但模型只有 2K 上限,效能數字也仍待跨硬體獨立重現。
 代理工具
NVIDIA 更新開源代理執行堆疊,重點處理 vLLM、llama.cpp、Ollama 與模型路由器的狀態漂移。新版也收緊沙盒生命週期、映像來源證明及失敗復原,但仍是快速迭代中的修補版本。
 代理工具
Nsight AI 現在可把即時 CUDA 文件接入 Codex、Claude 等 MCP 用戶端,或在本地部署完整的程式輔助後端。開源 Blueprint 結合生成、補全、嵌入及重排模型,但參考配置需要 Hopper 級 GPU 與至少 200GB 儲存空間。
 代理工具
NVIDIA 把原用於 GPU 核心演化搜尋的 AVO 代理架構移植至互動推理,搭配 Claude Opus 5 取得 100.00 RHAE。結果顯示代理記憶與驗證迴圈可大幅改變同一模型的表現,但只涵蓋公開環境,且與 VISTA 的比較不是受控消融。
 硬體
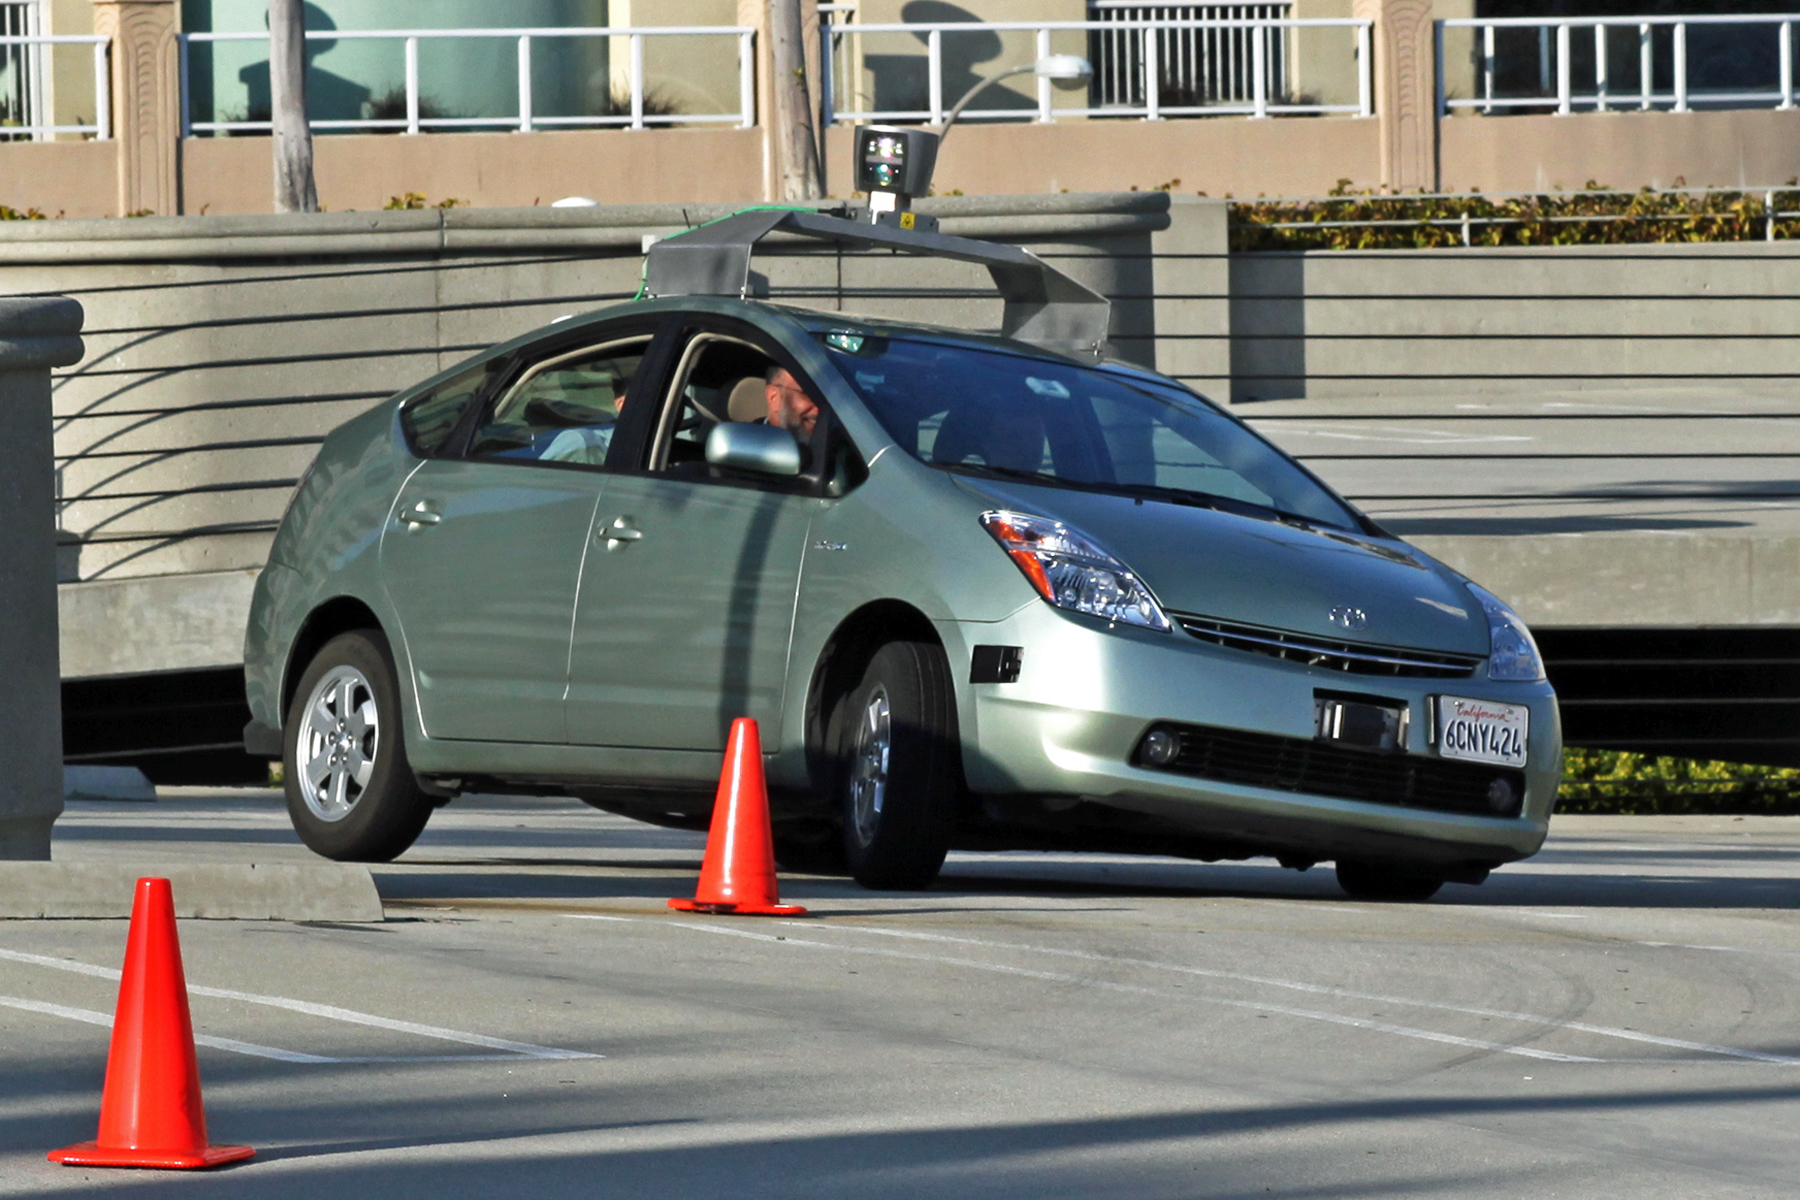
Waymo 首度披露 Robotaxi 的異構運算架構,自研 ASIC 負責即時整理相機、光達與雷達資料,再交給核心推論引擎。1,000 TOPS 未標示數值精度與功耗,不能直接與 NVIDIA 或 Tesla 的整車平台比較。
 硬體
VSPG 把每個動作存成單位超向量,將 softmax policy gradient 化為優勢加權向量疊加及正規化,不需 actor 的自動微分或最佳化器狀態。它在兩種建築控制氣候取得較佳回報並較耐位元錯誤,但效能高度取決於固定編碼器。
 AI 基礎設施
CS-4 並非改用新製程,而是提高 WSE-3 的時脈、供電與 I/O,再以三片晶圓級處理器組成 Nexus 機架。官方宣稱推論速度最高為 GPU 方案的 30 倍,但 PFLOPS 與每瓦吞吐數字仍缺少可比的獨立端到端測試。
 推論系統
一項預先註冊研究嘗試把專家局部性直接訓練進 MoE 路由器,卻發現快取改善與模型品質存在明顯交換。訓練與無訓練重路由疊加可再降低失誤,但仍未證明能轉化為等比例端到端加速。
 硬體
28 奈米 ETHEREAL 晶片把不規則事件圖存取與規則 spline convolution 分開處理,並支援逐層 4/8 位元精度。DAGr-GNN 量測達每事件 25.6 微秒、1.6 微焦耳,但最後三層偵測頭仍在晶片外評估。
 最新模型
OYS 不修改或蒸餾模型,而以貝葉斯最佳化為每個模型及任務尋找低步數去噪排程。研究在六款文字生成圖像模型及修補任務上報告改善,但搜尋成本需由大量預生成樣本攤銷。
 推論系統
Qwen3.8-27B 讓 27B 級模型進入單張 24GB 消費級 GPU 的可用範圍。公開資料顯示,一般 GGUF 部署約落在 30 至 60 tok/s;在 RTX 4090 上啟用 KV cache 量化、MTP 與新版 llama.cpp 後,社群實測可提升至 70 至 85 tok/s,但這仍不是開箱即得的基準。
 推論系統
NVIDIA 開源 TensorRT Model Connect,以兩道指令把受支援的 Hugging Face 或本機 checkpoint 建成可移交 C++ 應用的版本化 bundle。它縮短模型移植路徑,但目前定位仍是參考實作,支援範圍與效能須按模型、精度及硬體逐項驗證。