 硬體
CoTinyVLA、9億パラメータで7Bのロボティクスベースラインを上回るも、実験は依然シミュレーション環境に限定
CoTinyVLAは、35B教師モデルの階層的推論を0.9Bの視覚・言語・行動モデルへ蒸留し、LIBERO-Plusの4つのテストスイートすべてで最強の7Bベースラインを上回った。コード、訓練パイプライン、重みは公開済みだが、実機ロボット、異なるハードウェア、外部チームによる再現結果はまだない。
Archive
AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。
硬體
CoTinyVLAは、35B教師モデルの階層的推論を0.9Bの視覚・言語・行動モデルへ蒸留し、LIBERO-Plusの4つのテストスイートすべてで最強の7Bベースラインを上回った。コード、訓練パイプライン、重みは公開済みだが、実機ロボット、異なるハードウェア、外部チームによる再現結果はまだない。
 推論系統
NVIDIAの研究チームは、再学習を必要としないSol-Attnを公開した。注意演算中に重要なブロックを選択し、スキップしたブロックの寄与を近似的に補完する。公式評価では複数の動画モデルで約1.9~2.34倍のエンドツーエンド高速化を確認したが、品質とハードウェア間の汎化性能については、なお独立した検証が必要だ。
 推論系統
Dynamoの実験版がKimi K3のマルチモーダル処理、推論、ツール呼び出しの解析に対応し、集約型およびprefill/decode分離型のKubernetesレシピを公開した。このレシピは2.8T MoEの展開要件をラックトポロジー単位で定量化しているが、現時点では正式なQAを通過しておらず、GB200構成には既知の起動エラーも残っている。
 最新模型
Fermi Senseは、採点可能なECカタログ環境において、2基のGPUと約500ドルを使い、9Bのオープンモデルを達成可能スコアの87.3%まで訓練した。この成果は、強化学習によって企業ルールを小規模モデルに組み込める可能性を示す一方、評価データ、モデルの重み、完全な再現パッケージはまだ公開されていない。
 GitHub Repo
NVIDIAと30を超える組織がOpen Secure AI Allianceを設立し、モデル、エージェントフレームワーク、アイデンティティ、隔離、脆弱性スキャン技術を共有する計画を発表した。初期メンバーはNOOA、SPIFFE/SPIRE、Safetensors、Lightwell、MDASHなどの基盤コンポーネントを挙げているが、共通リポジトリ、テスト仕様、提供スケジュールはまだ公表されていない。
 代理工具
GitHubのオープンソース・エージェントワークフローツールがGoogle Vertex AI Workload Identity Federationに対応し、Geminiワークフローで長期有効なサービスアカウントキーを保存する必要がなくなった。新版では安全な出力チェックとBYOKパラメータも拡充されたが、カスタムヘッダーやリクエストフィールドは依然としてデータ流出のリスクを拡大する可能性がある。
 硬體
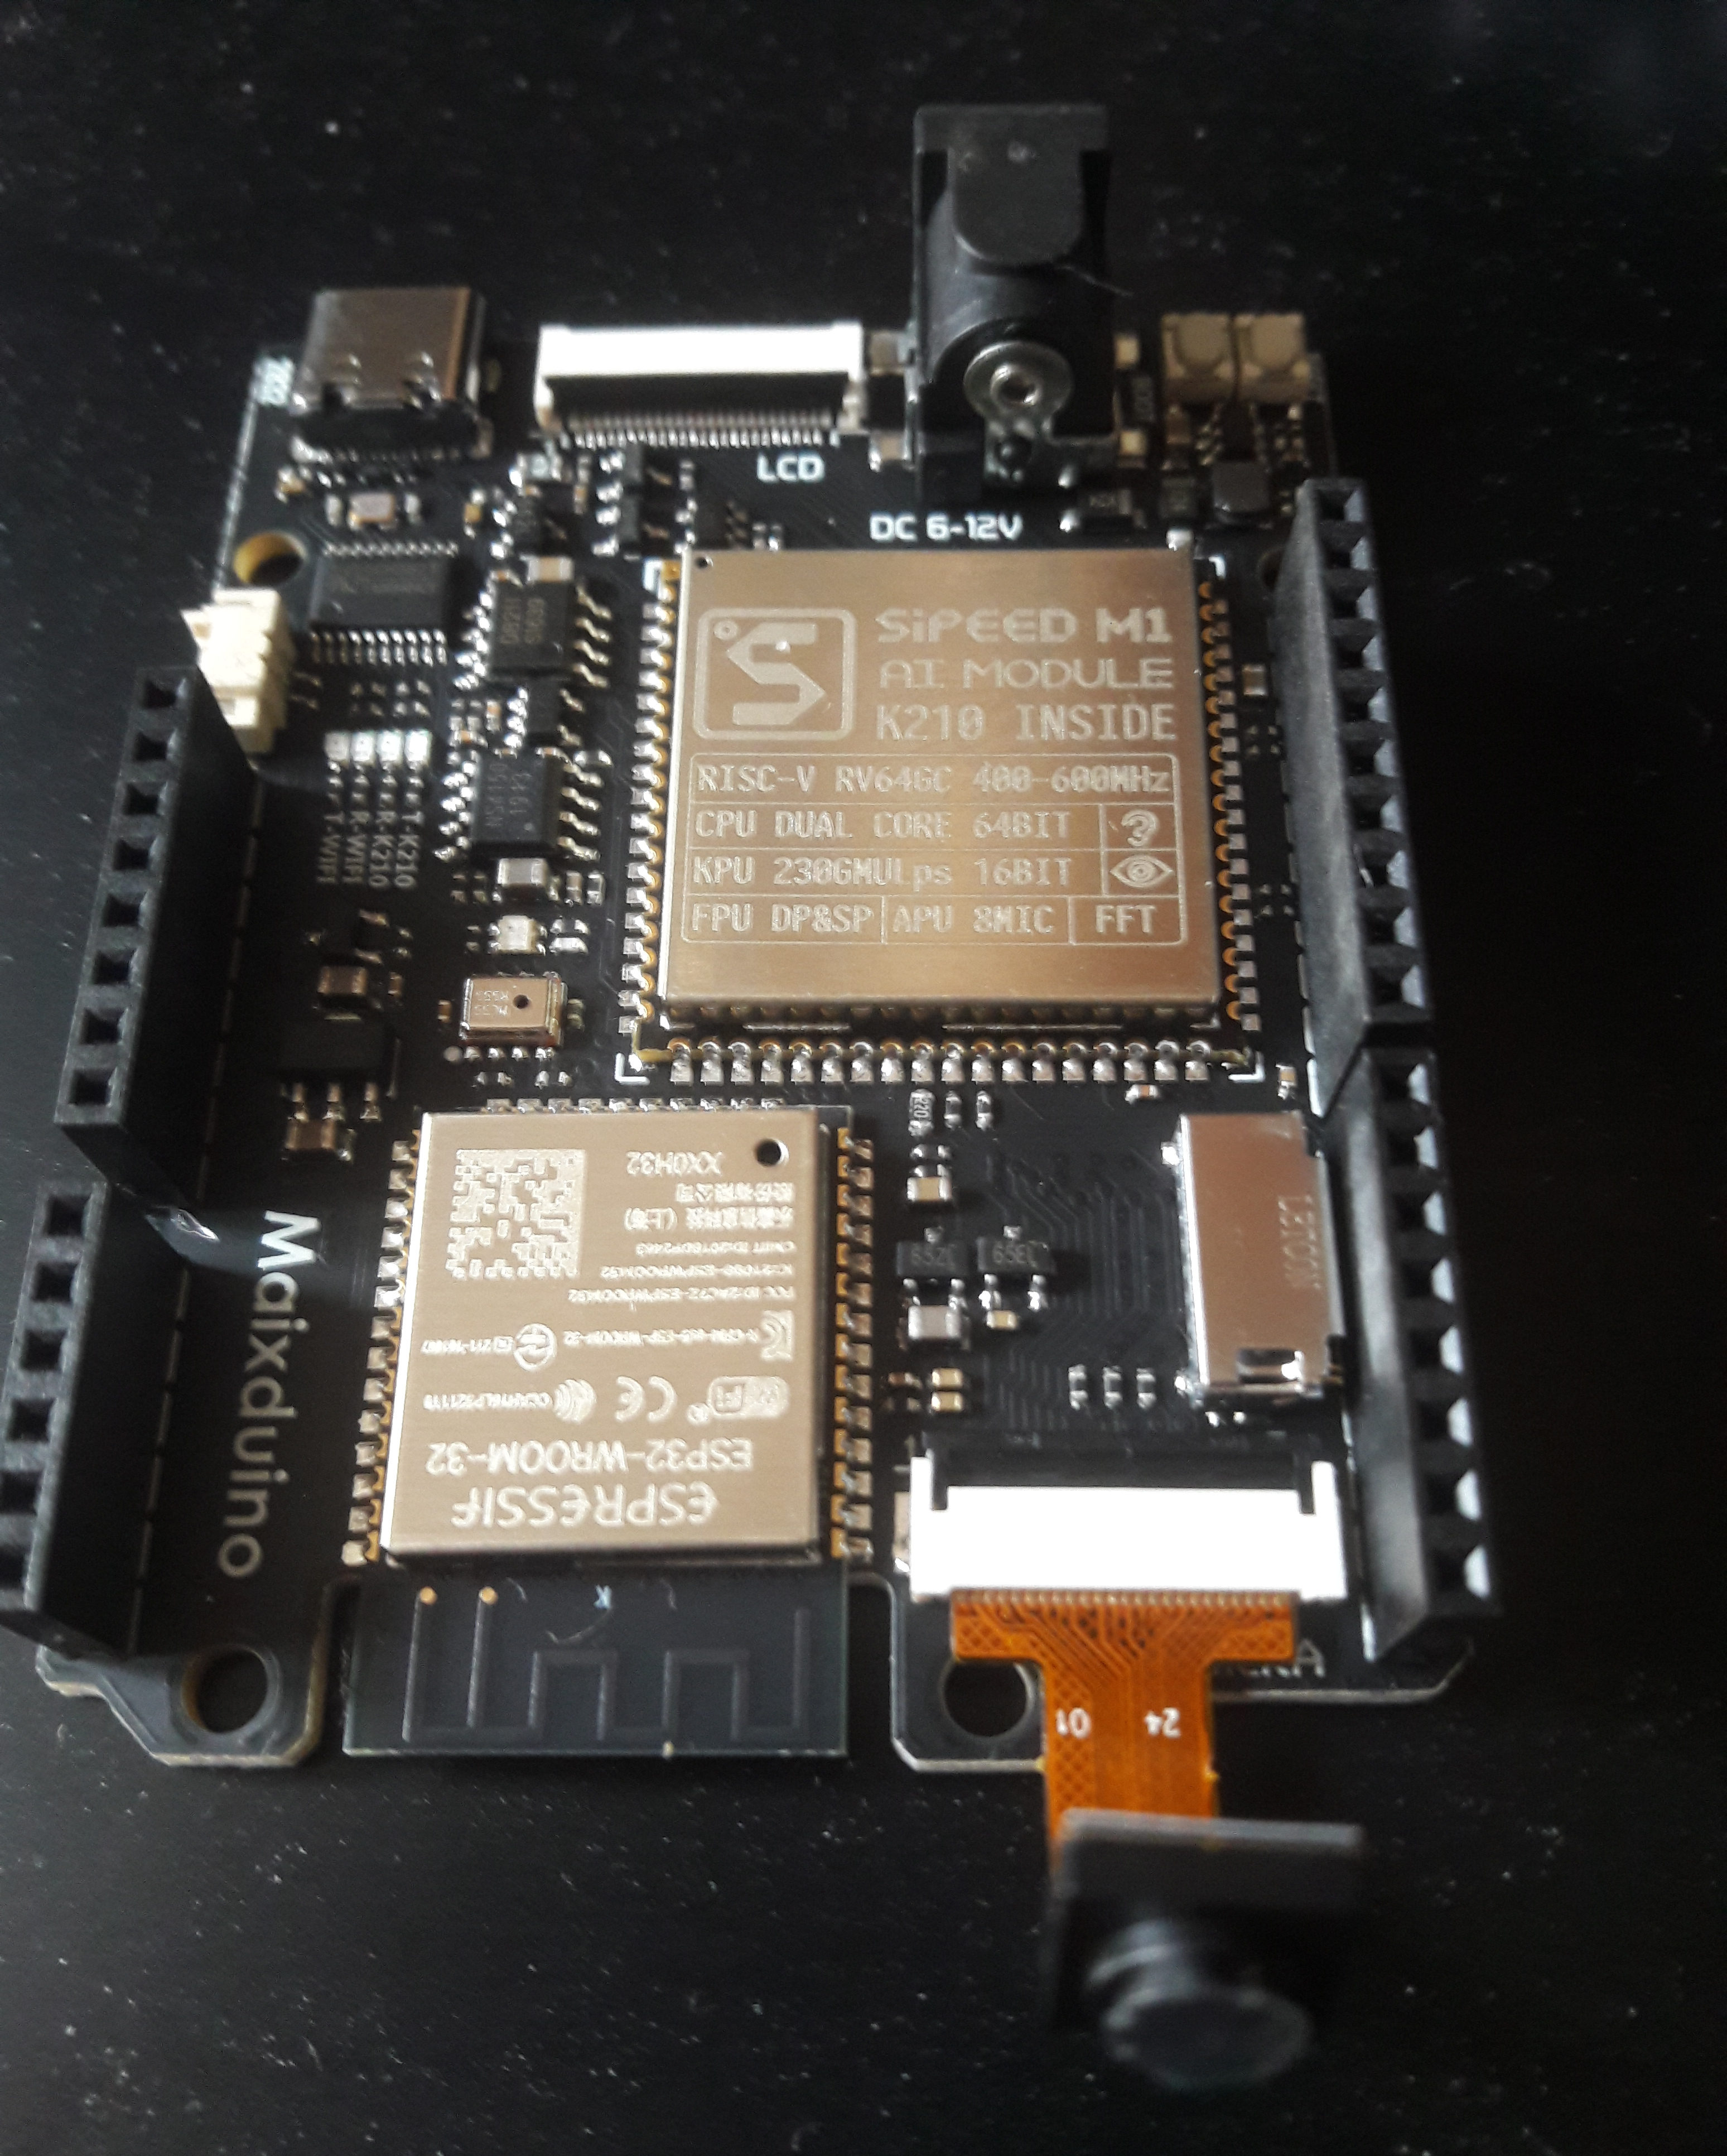
オープンソースプロジェクト「esp32-ai」は、パラメータの大部分をメモリマップドFlashへ移し、小型のTransformerコアだけを高速メモリに配置することで、約8ドルのマイクロコントローラーによる完全オフラインのテキスト生成を実現した。この成果は階層型モデルをファームウェアに組み込めることを示す一方、TinyStoriesレベルの出力を汎用的な言語理解やデバイス制御能力と同一視することはできない。
 硬體
NVIDIAはNemotron 3 Ultraを、生成・シミュレーション・リフレクションからなる固定ループに組み込み、CVDPの9種類のRTLタスクで平均合格率97.1%を達成した。エージェントフレームワークによって各モデルの成績が大幅に向上することも示されたが、比較対象は3つのオープンモデルと単一の評価フローに限られる。
 代理工具
NOOAはエージェントを単一のPythonクラスとして表現し、分散したプロンプトやツールschemaをメソッド、フィールド、docstring、型アノテーションで置き換える。公式発表ではSWE-bench Verifiedで82.2%を達成し、token使用量を約半分に削減したとしているが、フレームワークはまだ研究プレビュー段階にあり、モデルが生成したコードを実行する際には別途sandboxが必要だ。
 最新模型
Moonshot AIは7月27日、Kimi K3の完全版ウェイト、モデルカード、技術レポートを公開した。外部チームはこの3兆パラメータ級のスパースモデルを実際にデプロイし、監査できるようになった一方、少なくとも64基のアクセラレーター、カスタムコード、推論履歴への依存が明確な参入障壁となる。
 最新模型
NVIDIAは、少数ステップ拡散、自己生成履歴を用いた蒸留、ストリーミングKVキャッシュによって構築した手術ロボット向け生成シミュレーターを公開した。システムはロボットの運動データをリアルタイムで受け取り、次の映像区間を合成できるが、視覚的なリアリティは物理的な正確性や臨床検証の代替にはならない。
 代理工具
FluxBenchは、単発のコード出力だけでなく、統一されたプロンプト、ツール、プロセスライブラリを用い、エージェントがRTL生成から論理合成、配置配線、ECOまで完遂できるかを評価する。著者らは、同じ基盤モデルでもエージェントフレームワークによって性能に86.27%の差が生じ得ると報告している。ただし、商用EDAを用いた実験範囲は狭く、論文も一度撤回された後に再投稿されている。