硬體

AI 晶片、GPU、資料中心、邊緣裝置與硬體安全。

代理工具

ScienceFlow、実行可能なワークスペースをエージェントの記憶に統合し、75問のMLE-benchでAny-Medal率70.22%を達成

ScienceFlowは会話の要約を保存するだけでなく、コード、検証エビデンス、リソース記録、ワークスペースのスナップショットを、復元可能なStageとしてパッケージ化する。公式報告では、MLE-bench全75問でAny-Medal率70.22%を達成したが、システム間の比較は依然としてモデル、ハードウェア、時間予算の違いに左右される。
推論系統

llama.cpp b10456、SYCLの量子化変換スケジューリングを修正——Arc 70のQ4_0→FP32スループットが158.19 GB/sに向上

新版では量子化ブロックのサイズに応じてスレッド数とワークグループ数を設定し、SYCL copy kernelの過剰または不十分なサブスクリプションを回避。Arc 70のマイクロベンチマークではスループットが20.21 GB/sから158.19 GB/sに向上したが、これはモデル全体のtoken生成速度が同じ比率で向上することを意味しない。

最新模型

Intern-S2-Mobius、FFNの記憶をモデル全体で共有し、35Bモデルで約4倍のエンドツーエンド推論高速化を報告

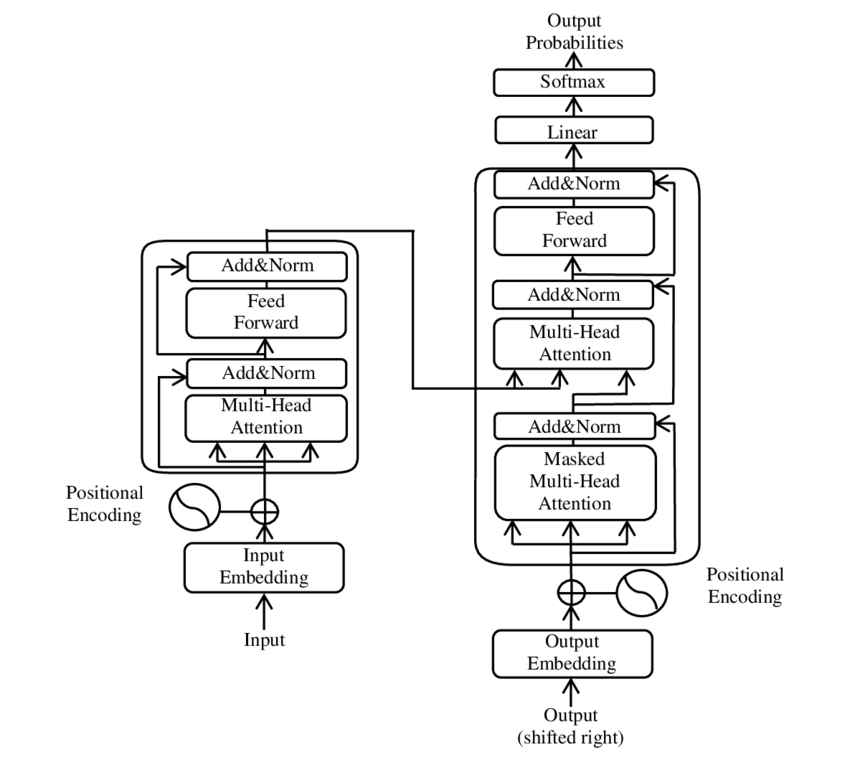
Intern-S2-Mobiusは、従来のTransformerで各層に結び付いていた知識ストレージと注意機構による推論を分離し、複数のReasonerが同一のグローバルMemoryを繰り返し参照できるようにする。オープンウェイトはLMDeploy、vLLM、Transformersで読み込めるが、約4倍という高速化は、あくまで公式の特定ベンチマークにおける結果だ。

代理工具

Pydantic AI 2.31、AG-UIの実行識別子をイベントストリームへ移行し、入力が遅延しても先にストリームを作成可能に

新版では、`run_input`をまだ取得していなくても`UIEventStream`を作成でき、`AGUIEventStream`がthread IDとrun IDを自身で保持するようになった。Temporal sandboxとの互換性やフォールバックモデルのtracingの帰属も修正され、長時間稼働するエージェントワークフローにおける診断上の盲点が減少する。

最新模型

SpaceXがCursorの買収を完了、ComposerのトレーニングとGrok開発ツールチェーンを同一スタックに統合へ

CursorはSpaceXAIへの参加を確認し、両社はGrok Build、Grok Bot、Grok API、Cursorを共同で改良する。今回の取引により、GPUインフラ、コーディングモデルのトレーニング、数百万人規模の開発者向けチャネルが垂直統合されるが、モデル、データ、APIの移行スケジュールはまだ発表されていない。

最新模型

Gemini 3.7 Flashはコーディングエージェントに注力、LiteLLMは`minimal`推論レベルでHTTP 400が直接返されると注意喚起

GoogleはGemini 3.7 FlashをAPI、Antigravity、Android Studio、企業向けエージェントプラットフォームへ展開し、期間限定の半額料金で高トラフィックなエージェントワークロードへの浸透を図る。初期の統合ではマルチモーダル、ツール呼び出し、複数のAPI形式が利用可能になっている一方、推論パラメータとコストデータには依然として移行上の落とし穴がある。

生成式 AI 工具

ComfyUI 0.33.1がMiniMax Music 3とCUDA Graphにネイティブ対応、非dynamic VRAMモードの問題も修正

ComfyUI 0.33.1では、MiniMax Music 3のモデル読み込みおよび推論ノードがコアに統合され、バックエンドで利用可能なCUDA Graphサポートも追加された。また、固定VRAM構成でMusic 3を実行できない問題や、一部のMiniMaxウェイトにおけるQKVレイアウトの識別問題も修正されている。

推論系統

vToken、KVキャッシュをトークン単位で仮想化し、メモリ制約下の最大同時実行数を2倍に

vTokenは既存のPagedAttentionに論理トークンテーブルと非同期コンパクションを追加し、トークン単位の退避によって物理ブロックを実際に解放できるようにする。vLLMプロトタイプではSLA制約下のスループットが最大1.37倍に向上したが、コードはまだ公開されておらず、移動コストがあらゆるハードウェアとトラフィックに適することも実証されていない。

最新模型

GLM-5.3、5.2の基盤モデルを継承してポストトレーニングを拡大、サイバーセキュリティ能力の急伸でオープンウェイト公開を2週間延期

Z.aiによると、GLM-5.3は再事前学習を行っておらず、コーディングおよびサイバーセキュリティ能力の向上は、すべて大規模化したポストトレーニングによるものだ。CyberGymでは84.5%の成功率を報告したが、ウェイトはデュアルユースリスク評価の完了後に公開される。

最新模型

LittleLearner、事前学習知識を小学5年生レベルに制限—高度な数学への少数ショットプロンプティングでも約6%にとどまる

研究チームはFineWeb‑Eduから880億tokenのK–5コーパスを抽出し、0.6B、1.3B、5Bモデルと、計算量を揃えた対照モデルをゼロから学習させた。実験の結果、モデルの大規模化、SFT+GRPO、コンテキスト内の例示は主に既存の能力を引き出すものであり、事前学習知識の境界を明確に越えることはなかった。

推論系統

RMM、入力に応じて行列乗算の縮約軸を枝刈り――Llama 3.1 8Bの長文コンテキストで最大1.40倍高速化

Reduced Matrix Multiplicationは重みを変更せず、現在のactivationの列ノルムに基づき、行列乗算でスコアが最も高い共有次元のみを計算する。A100でのテストでは、シーケンスが長くなるほど効果が増した一方、短いコンテキストでは選択処理とkernel起動のコストが計算削減分をほぼ相殺した。