 推論系統
GCache 依全程誤差影響配置擴散快取,Wan2.1 同速下 LPIPS 降至 0.0316
GCache 不再以相鄰去噪步驟的局部相似度決定是否重算,而是搜尋對最終畫質影響最低的快取重用序列。它在 Wan2.1 維持 2.17 倍加速時大幅降低偏差,但策略搜尋需要多張 H100,實作亦尚未公開。
Archive
GitHub 熱門專案、開源工具、框架、runtime 與重要 release。
推論系統
GCache 不再以相鄰去噪步驟的局部相似度決定是否重算,而是搜尋對最終畫質影響最低的快取重用序列。它在 Wan2.1 維持 2.17 倍加速時大幅降低偏差,但策略搜尋需要多張 H100,實作亦尚未公開。
 推論系統
vToken 在 PagedAttention 區塊之上加入 token 對實體位置的映射,將淘汰後散落的 KV 空洞重新壓實。vLLM 原型最多減少 72.3% 保留區塊,但測試仍限於單機單卡與 7B、8B 級模型。
 AI 基礎設施與訓練系統
LazyTrain 在訓練前聯合決定 activation 保存、卸載及重算位置,把 PCIe 與 NVMe 傳輸塞入 GPU 計算窗口。Qwen3.6‑27B 實驗由 176.90 提高至 219.95 TFLOPS,但目前只驗證單卡與離線排程。
 推論系統
新方法針對數千至一萬個合法字串預先建立 trie 狀態與 token mask,避開通用文法編譯的基數瓶頸。作者測得批次 256 時每秒處理 219 個請求,但尚未公開實作,數字也包含繞過既有 guided-decoding 路徑的整合收益。
新研究發現,混合線性注意力模型的巨量啟用並非隨機散布,而會在完整注意力層前形成尖峰,並於中間的線性層維持平台。團隊公開分析程式與受控模型,但完整論文圖表所用的逐筆輸入尚未全部釋出。
 代理工具
一項新研究以廣義性理論拆解 TheAgentCompany、τ²-bench 與 AppWorld,發現代理與任務的交互作用遠大於代理本身的平均差異。作者提出 DDR 報告框架,要求選型時同時交代任務難度、留出驗證、成本與所需樣本量。
 代理工具
LLNL 團隊讓代理探索 Flux、Slurm、Kubernetes 等資源,再把高階意圖轉成可驗證的工作規格。六個雲端叢集實驗顯示架構、網路與記憶體 metadata 主要能排除不能執行的機器,並非穩定的效能最佳化器。
 代理工具
Graph-Structured Rubrics 在看見待評答案前,先把自然語言 rubric 編譯成具型別的判斷、轉換、聚合與閘門節點。GPT‑OSS‑120B 實驗顯示它優於平面式 Prometheus 評分,但目前未公開程式,增益亦高度依賴資料集。
 最新模型
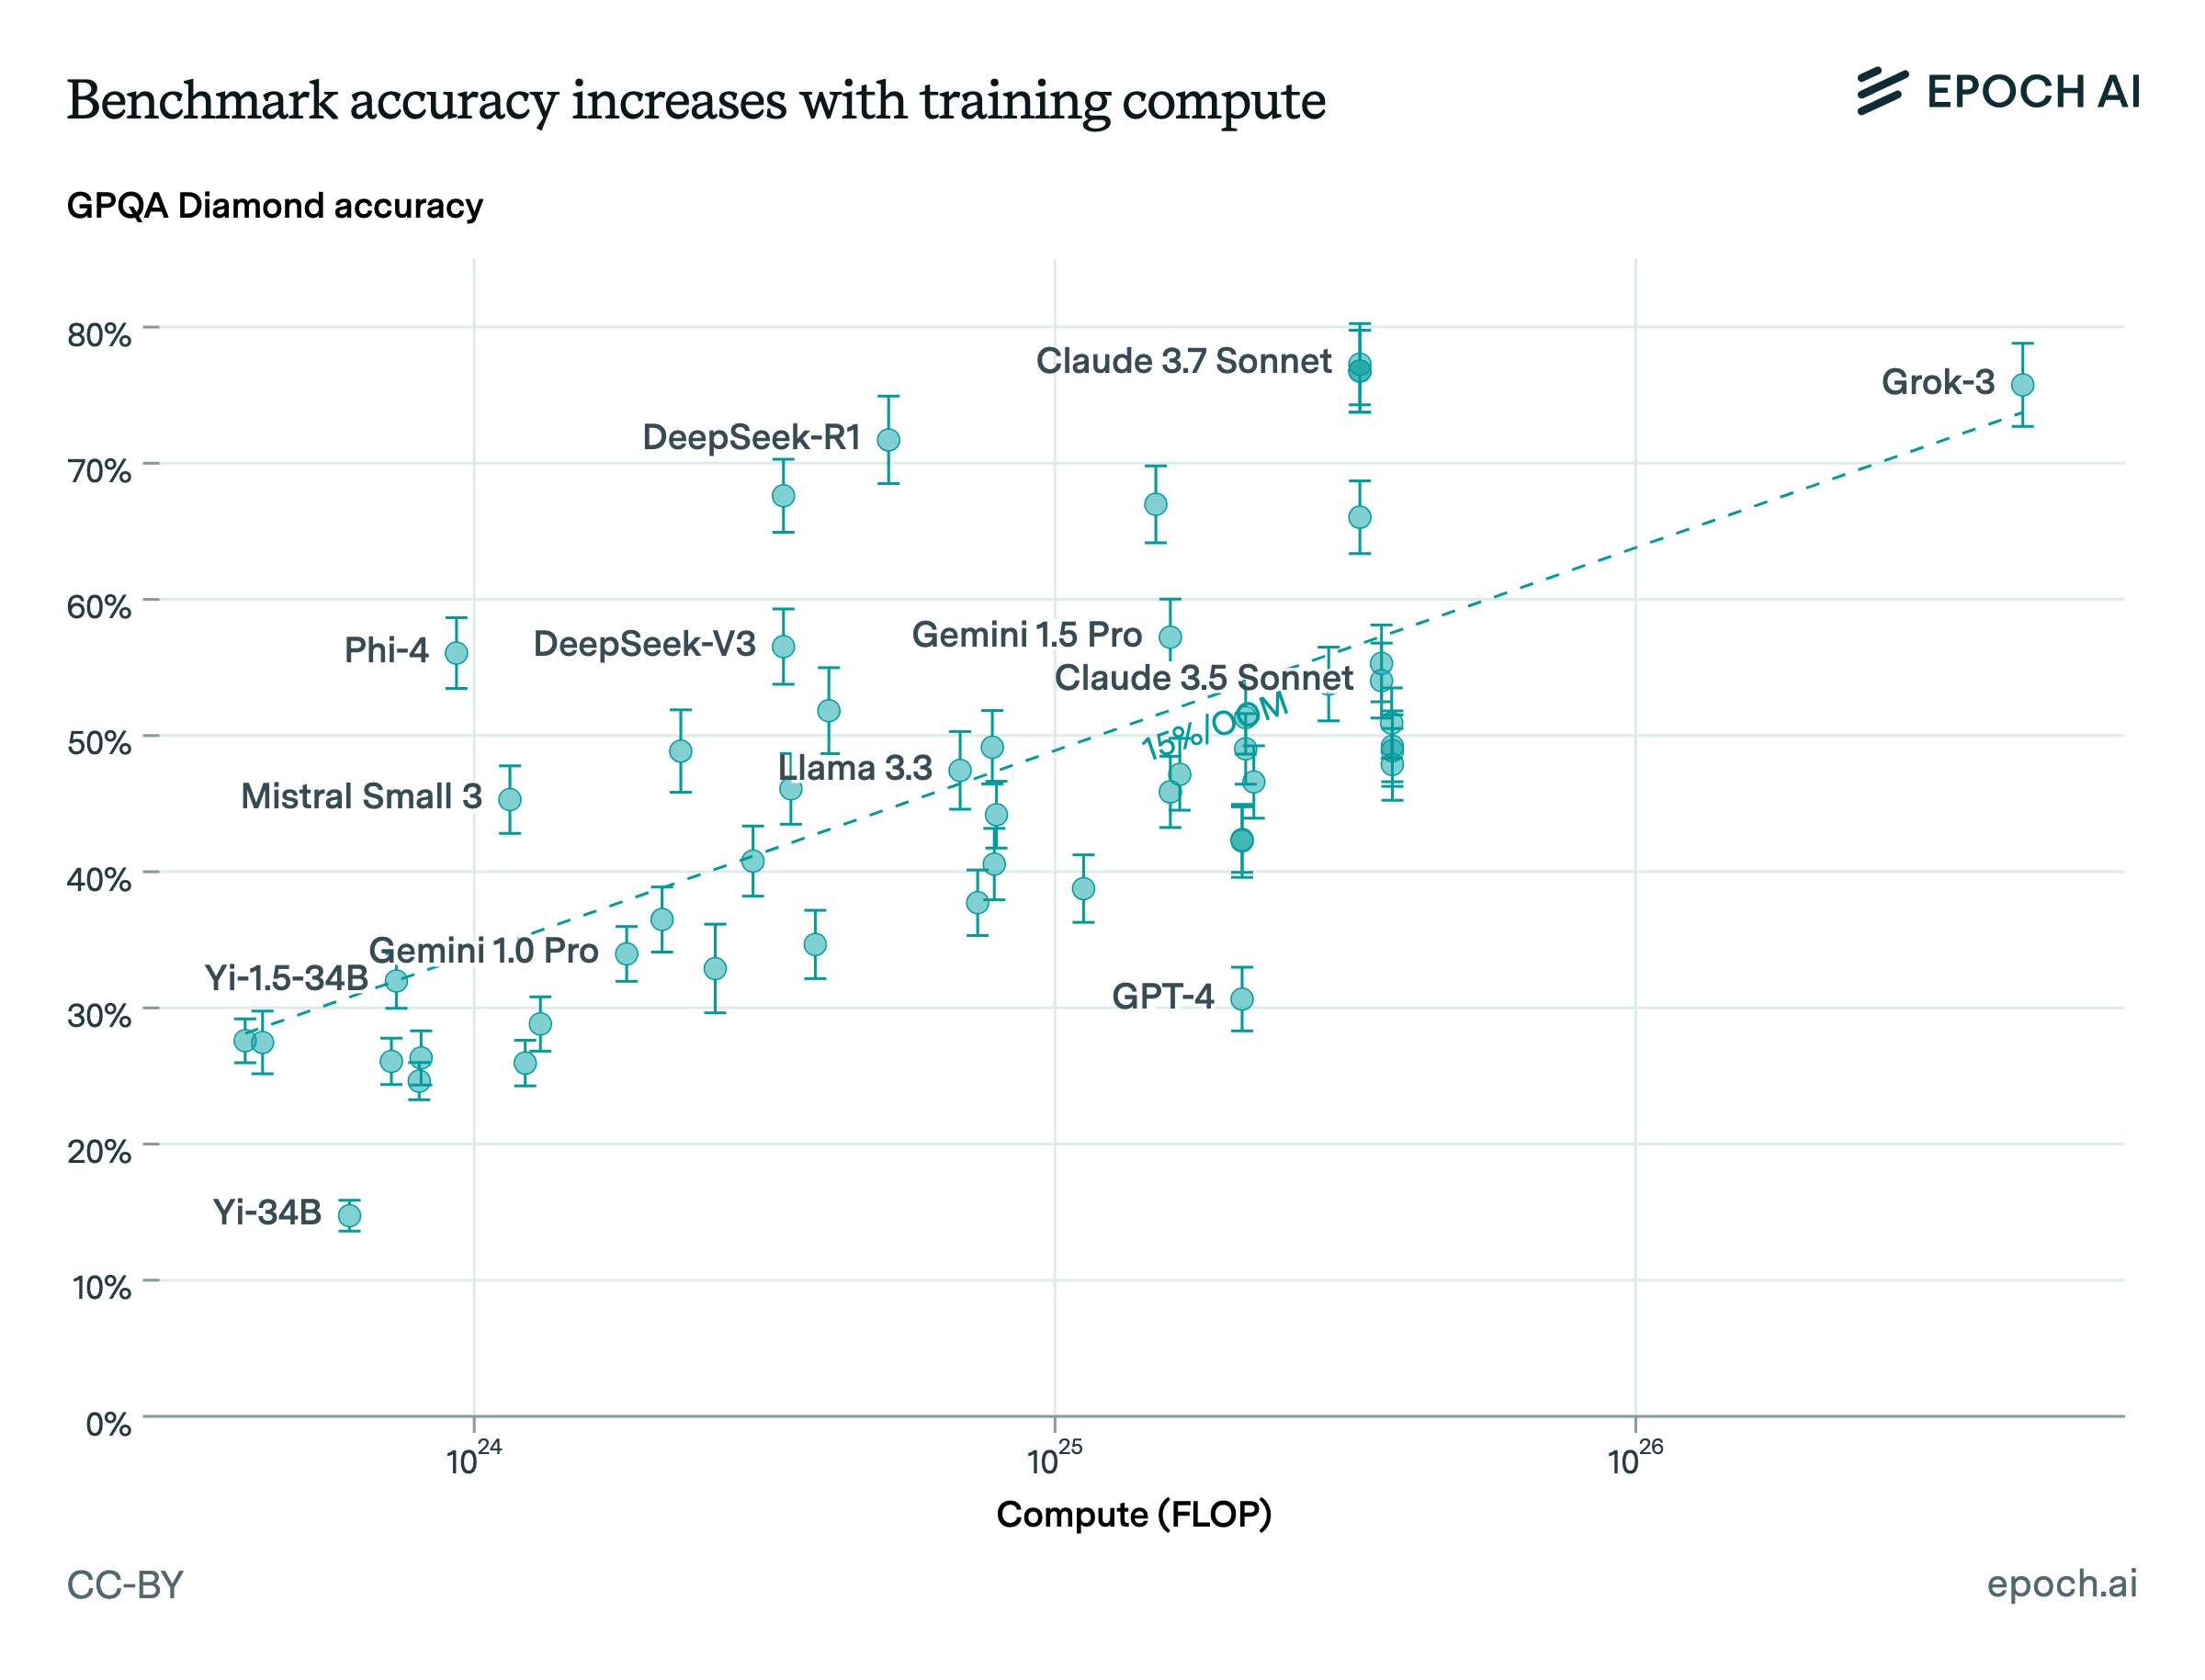
一項預先註冊研究發現,Qwen2.5-7B 與 Llama-3-8B 在多數 GPQA Diamond 題目上愈投票愈容易鎖定錯誤答案。整體平均分數仍略升,顯示聚合指標會掩蓋逐題退步。
 最新模型
MiniMax H3 以單一 Transformer 聯合預測影音 latent,支援文字、首尾幀及多模態參考生成。公開版本可本機產生 768p 影音,但官方 2K 流程仍依賴兩個未開源的雲端模組。
 最新模型
LTX‑2.5 公開 22B 可訓練及八步蒸餾權重,新增跨鏡頭角色、聲音與場景一致性。完整快速入門元件約 66 GiB,Diffusers 支援仍須安裝主分支,模型也受營收門檻式社群授權限制。
 最新模型
阿里千問公開 Qwen3.8‑2.4T‑A95B,以 512 個專家、混合線性與標準注意力支援最長約 101 萬 token。模型可調整推理深度,但只接受文字、不能關閉思考模式,實際部署門檻遠高於一般開放權重模型。