 AI 安全
JailbreakSkill 將越獄策略封裝成可進化技能,HarmBench ASR 再增 13.4 個百分點
JailbreakSkill 以統一介面封裝提示改寫、失敗分析及技能演化,讓紅隊代理從未成功的攻擊軌跡產生新程序。第二階段令 AdvBench 與 HarmBench 的跨模型平均攻擊成功率分別再升 17.5 及 13.4 個百分點,但評分依賴 GPT-4o 裁判。
Archive
GitHub 熱門專案、開源工具、框架、runtime 與重要 release。
AI 安全
JailbreakSkill 以統一介面封裝提示改寫、失敗分析及技能演化,讓紅隊代理從未成功的攻擊軌跡產生新程序。第二階段令 AdvBench 與 HarmBench 的跨模型平均攻擊成功率分別再升 17.5 及 13.4 個百分點,但評分依賴 GPT-4o 裁判。
 推論系統
ParaTempo 定期探測各條推理路徑的暫定答案分布,據此獨立執行裁切、提前退休及分叉。Qwen3.5-35B-A3B 的四項評測平均準確率較固定 16 路 self-consistency 低 1.1 個百分點,但延遲與生成 token 分別減少 21.8% 及 30.3%。
 推論系統
新版在 Linux HIP 建置中停止以系統 `MemAvailable` 覆寫 GPU 記憶體資訊,改為信任 `hipMemGetInfo`。修正針對可調 UMA carveout 的 AMD APU,可降低模型載入器高估容量後才失敗的風險。
 代理工具
PACE-Bench 用 144 組可執行物理環境,測試代理能否修正曾經成功、但在摩擦力或材料限制改變後失效的程式設計。實驗顯示反思優於未驗證自我修訂,而長期記憶反會把較強模型綁在早期方案。
 訓練基礎設施
Rollplex 把參考模型與訓練 actor 的影片編碼、prompt prefill,提前至自回歸解碼期間執行,同時維持同步 on-policy 語義。系統以 CUDA VMM 管理跨階段記憶體,並讓不同張量平行度的訓練與推論程序共用相容權重。
CForce 沿用擴散語言模型自己的生成軌跡,把後期較完整的預測蒸餾回早期遮罩狀態。LLaDA2.1-mini 在提高平行解碼量的同時維持準確度,但證據目前集中於同一模型家族與作者控制的評測。
 最新模型
sMuon 先把完整權重的正交化方向投影至 LoRA 因子可表達的低秩空間,再以純矩陣乘法計算更新。方法在 ReLoRA 實驗追平 Riemannion 的最低驗證損失,但跨模型微調結果顯著依賴基礎模型原先使用的最佳化器。
 代理工具
ScienceFlow 不只保存對話摘要,而是把程式、驗證證據、資源紀錄與工作區快照封裝成可恢復階段。官方在完整 MLE-bench 報告 70.22% Any-Medal 率,但跨系統比較仍受模型、硬體與時間預算差異影響。
 推論系統
新版依量化區塊大小配置執行緒與工作群組,避免 SYCL copy kernel 過度或不足訂閱。Arc 70 微基準吞吐由 20.21 升至 158.19 GB/s,但這不是完整模型的 token 生成加速比。
 最新模型
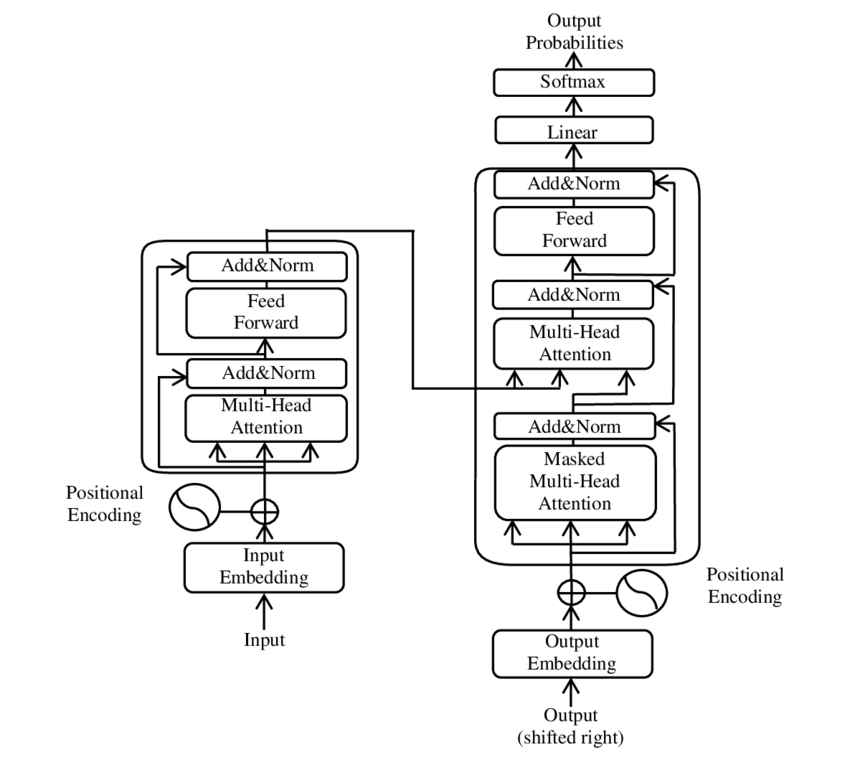
Intern-S2-Mobius 把傳統 Transformer 各層綁定的知識儲存與注意力推理拆開,讓多個 Reasoner 反覆查詢同一組全域 Memory。開放權重可由 LMDeploy、vLLM 或 Transformers 載入,但近 4 倍加速仍是官方特定評測結果。
 最新模型
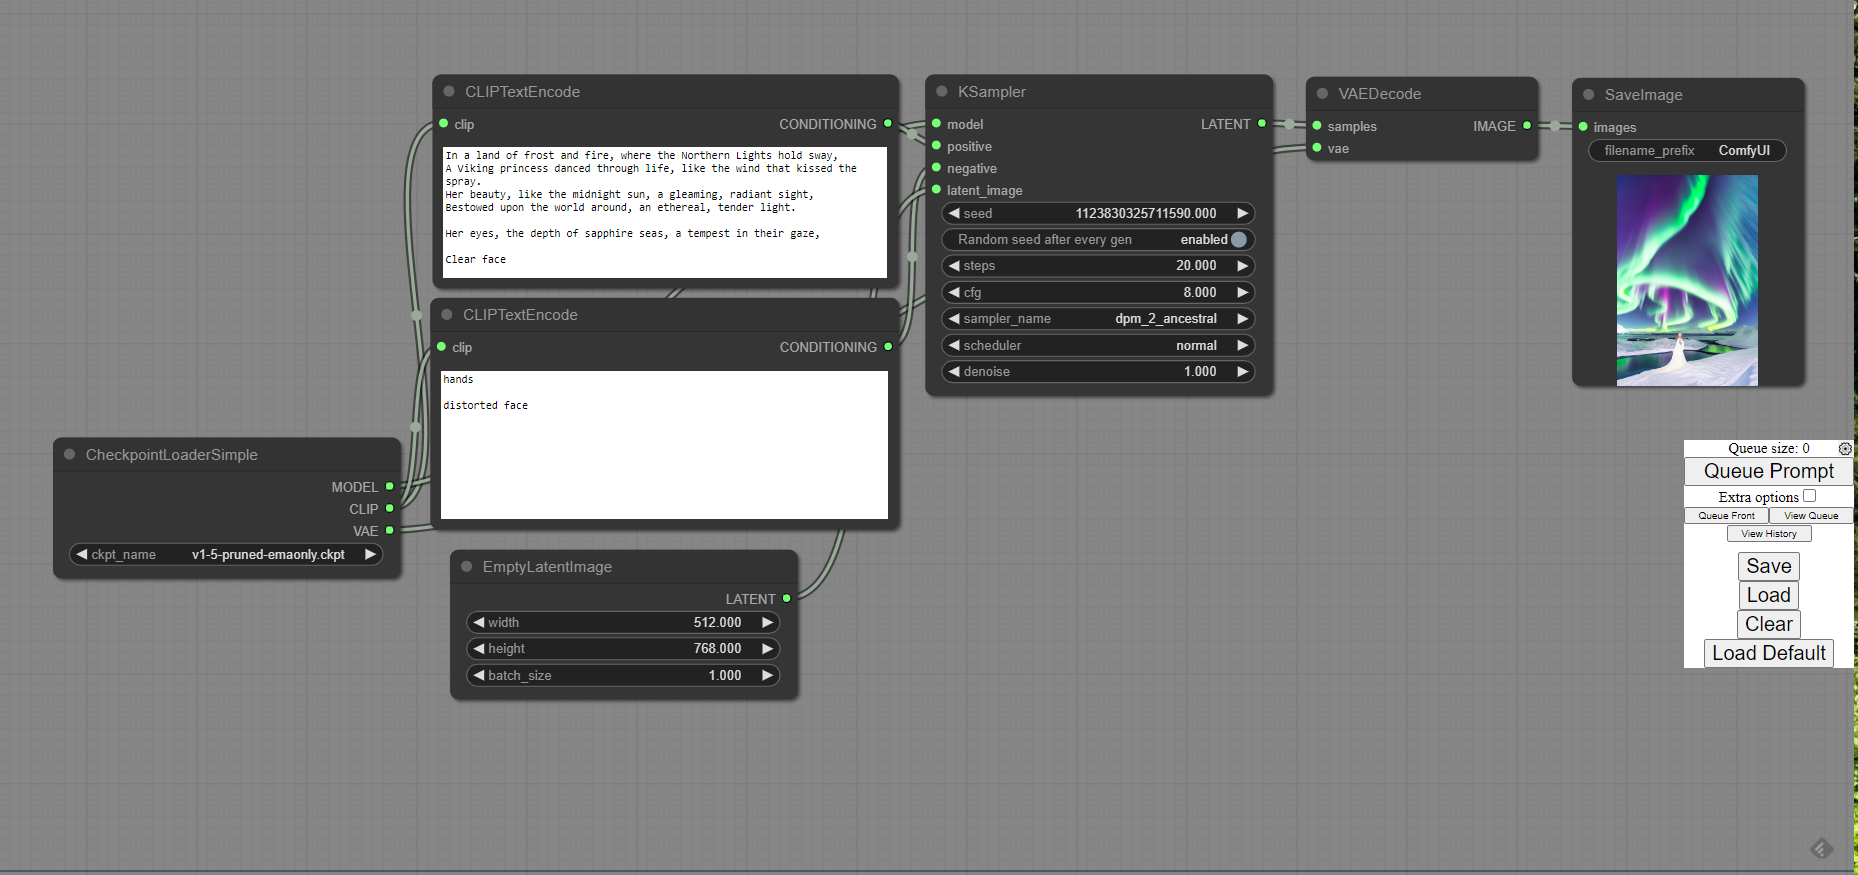
社群為影片模型 MiniMax H3 訓練 5.21GB 單幀 VAE,讓 reference-to-video 管線只生成一幀即可執行換裝、改姿勢與視角變換。方法展示影片模型可被重用為影像編輯器,但目前依賴非官方權重、特定工作流及尚未完全落地的 ComfyUI 單幀介面。
 代理工具
英國 AI Security Institute 開源 optstop,按題目與任務層級的後驗不確定性決定何時停止重複評測。九組影子測試平均省下 81.1% 試驗,但效果依評分型態、題目排序及交換性假設而變。