GitHub Repo

GitHub 熱門專案、開源工具、框架、runtime 與重要 release。

LLMOps

Grafana Agent Observabilityが正式提供開始、オープンソースSDKでオンライン評価とエージェントCIを連携

Grafanaは、社内で利用してきたエージェント可観測性プラットフォームを正式提供し、5言語と複数のエージェントフレームワークに対応するagento11y SDKを公開した。同プラットフォームは、会話、ツール実行、コスト、OTel traces、オンライン評価、オフライン実験を単一の回帰テストフローに統合するが、製品の全機能は依然としてGrafana Cloudに依存する。
代理工具

RepoComplianceBench:4つのコーディングエージェントは、オープンソースプロジェクトのAIコントリビューション規則をほぼ自発的に確認しない

49の実在するリポジトリから抽出した106件のタスクを用い、拒否、開示、検証、人間への引き継ぎに関する規則を評価した。4つの最先端モデルはいずれも、デフォルトではポリシーを自発的に探すことがほとんどなかった。規則の明示や検証器の導入により開示とテストは改善したものの、エージェントはすべての評価条件で「AIによるコントリビューション禁止」という要件に従わなかった。

代理工具

MANTA、推論中にマルチエージェント・トポロジーを再構成し、5つのベンチマークで平均5.8ポイント向上

MANTAはタスクに応じてエージェント通信グラフを構築し、実行トレースから協調上の異常を検出して、役割、接続、検証順序を限定的に書き換える。Gemma 4 31Bを用いたテストでは、5つのベンチマークにおける平均スコアが74.0に達したが、実験のサンプル数と反復回数は依然として少ない。

推論系統

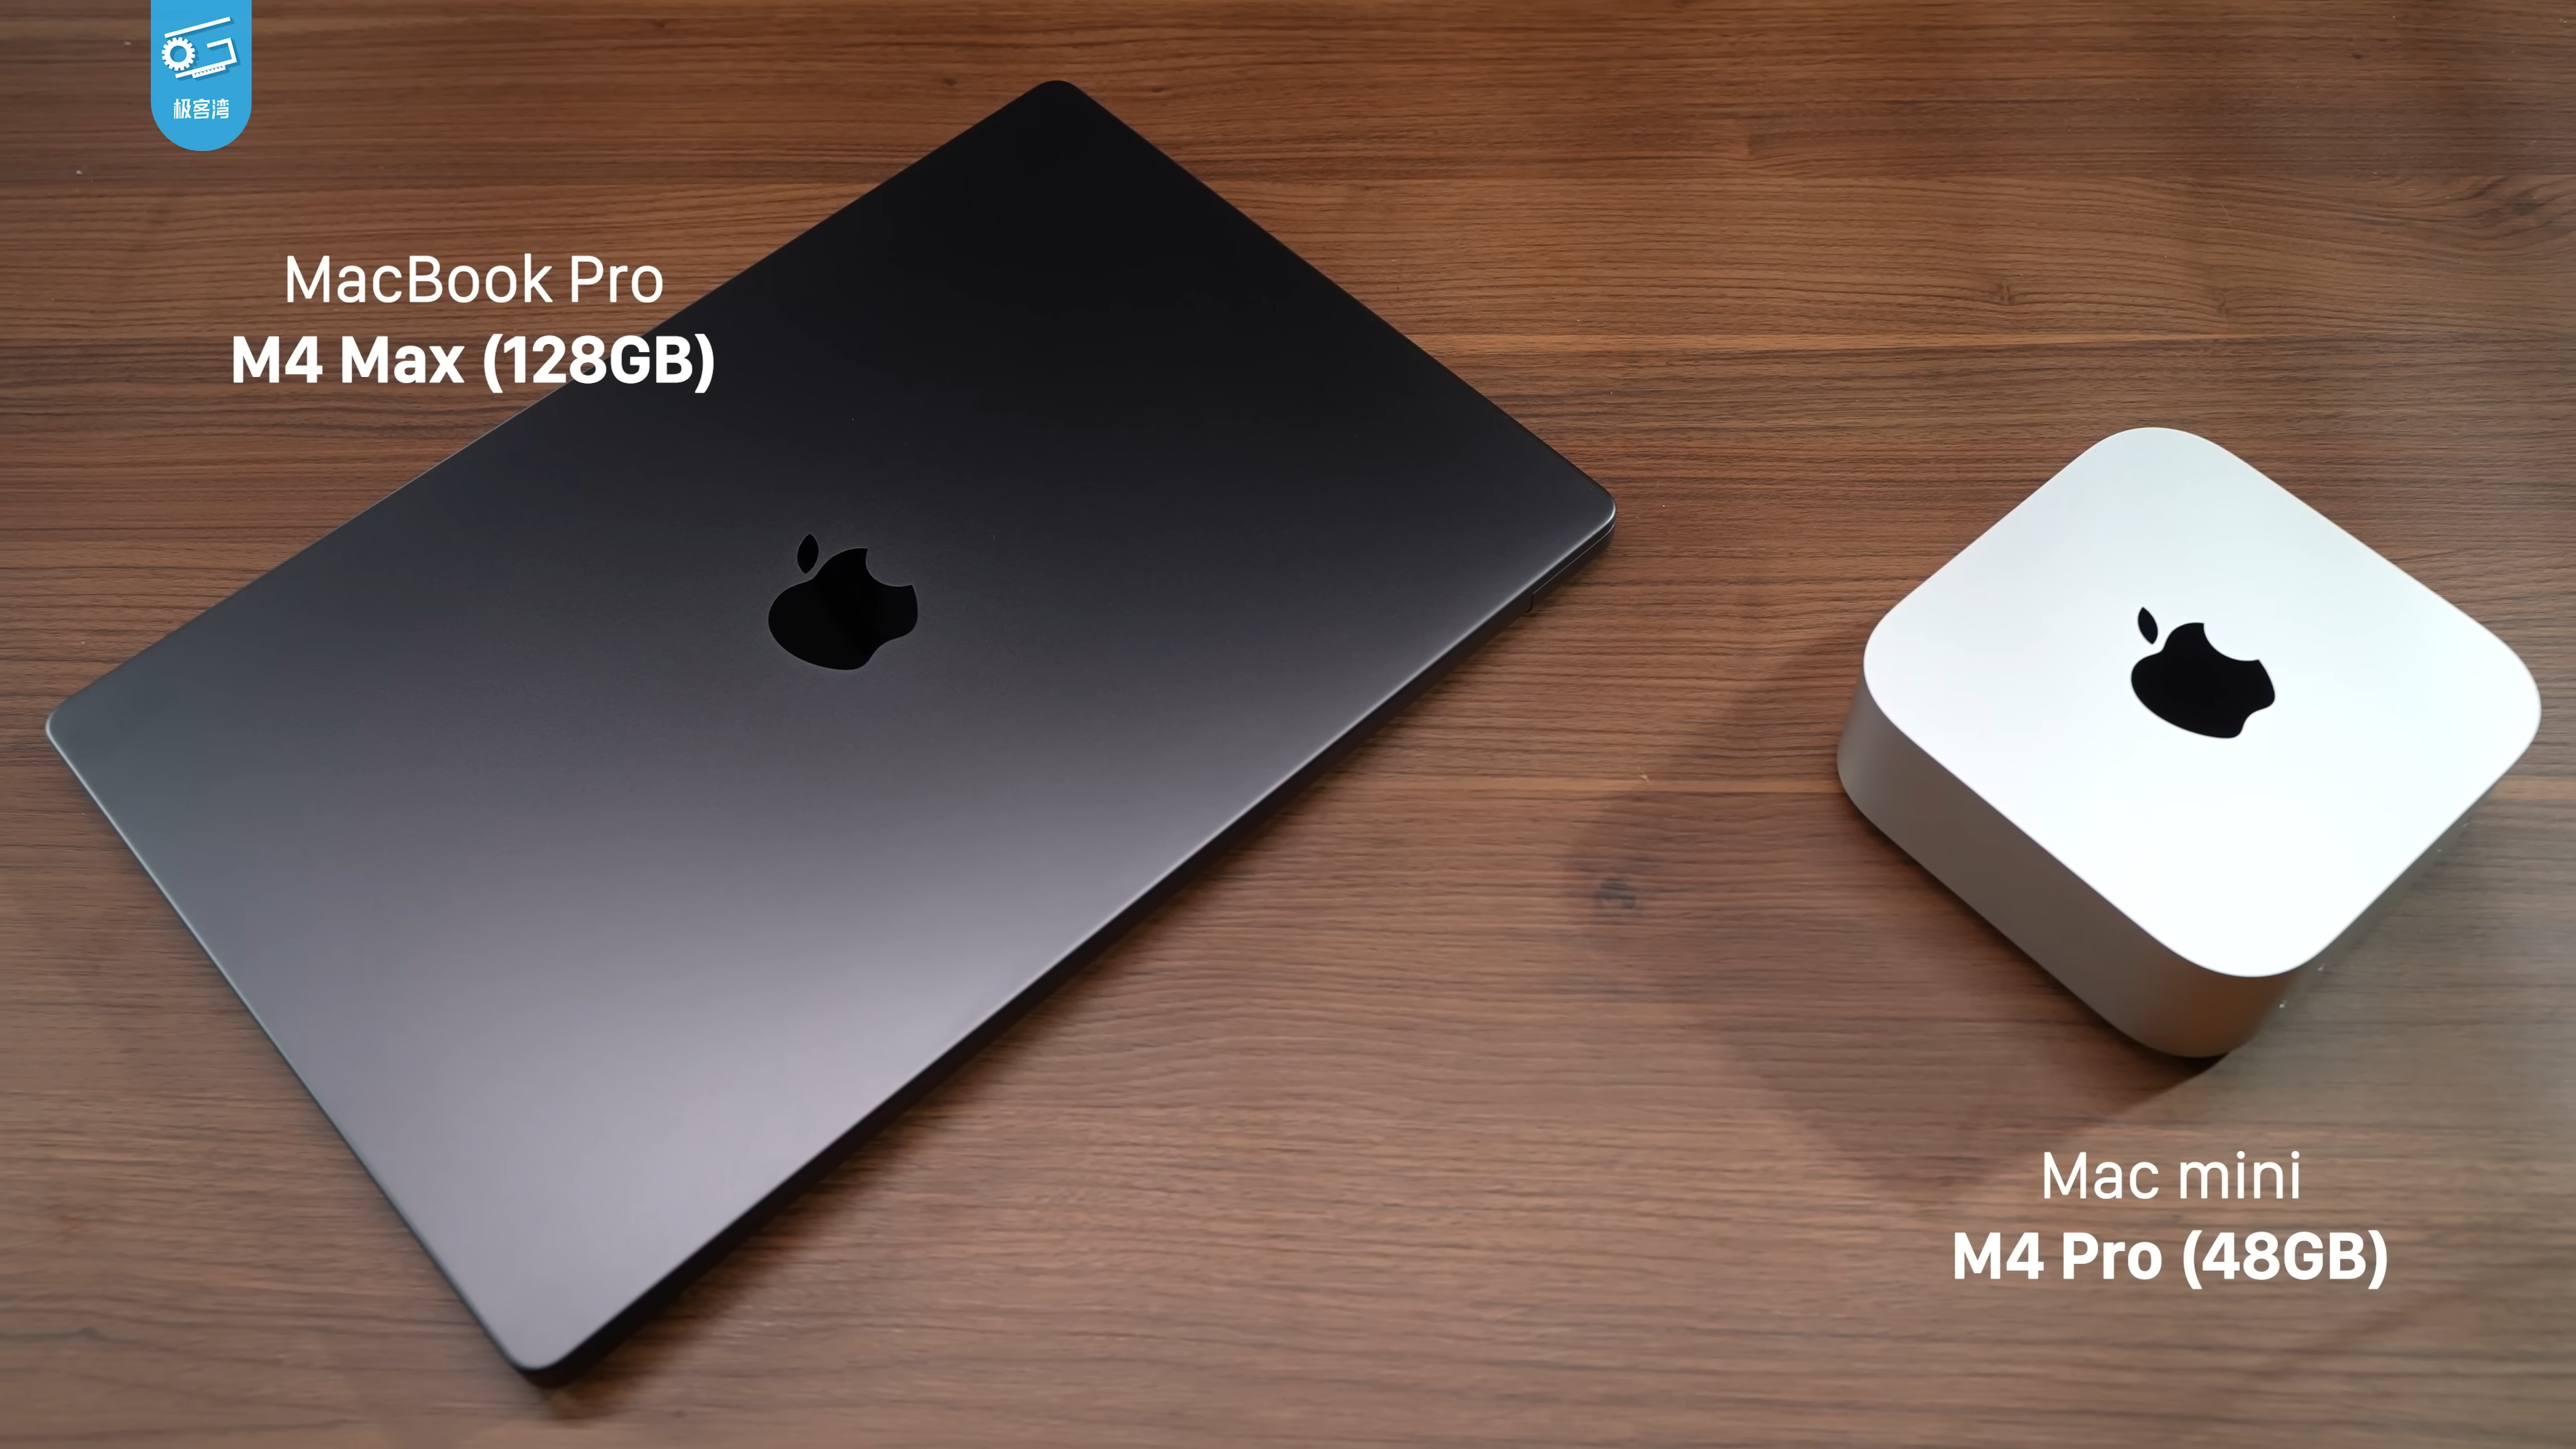
M4 MaxのローカルLLM実測:デコードはGB10より高速、ただし応答全体は依然としてprefillが制約

同価格帯のローカルAIプラットフォームを比較した最新テストでは、546GB/sのユニファイドメモリ帯域幅を備えるM4 Maxが、3種類の量子化モデルにおけるtoken単位のデコードでGB10とStrix Haloを上回った。一方、prompt prefillと総合的な電力効率ではGB10が依然優位であり、tokens/sだけを見ると実際の応答時間を見誤る可能性がある。

開發者平台/API

GitHub Modelsが正式にサービス終了、推論API、モデルカタログ、BYOKも同時に提供終了

GitHubは7月30日、Modelsのplayground、モデルカタログ、推論API、bring-your-own-key(BYOK)機能を終了した。既存の有料ユーザーも例外ではない。同サービスのエンドポイントに依存するアプリケーションは、Microsoft Foundry、別のモデルgateway、または自前のプロバイダー抽象化レイヤーへ移行する必要がある。

代理工具

5つのコンピューター操作エージェント・ベンチマークを再検証:失敗判定の15.3%は誤りだった

研究チームが「失敗」とされた公開トラジェクトリ150件を人手で再検証したところ、10.7%はgraderの偽陰性で、さらに4.7%は達成不可能なタスクに起因していた。真の失敗も、マウスの位置指定やツール実行ではなく、主にプランニングと結果検証で発生していた。

AI 安全

MIND、意図情報ボトルネックでエージェントのメモリをフィルタリングし、攻撃成功率を平均55%超低減

MINDは、メモリ項目ごとに大規模モデルを呼び出して審査するのではなく、元の意図とその後の行動の圧縮表現を比較し、複数超平面分類器でポイズニングされたコンテンツを遮断する。4モデルを用いた対照実験では攻撃成功率が低下し、平均レイテンシは防御なしのベースラインに近かったが、コードはまだ公開されていない。

最新模型

AgenticASR、スライディングウィンドウで文字起こしを反復修正—1B Refinerが日中バイリンガル評価を79.95点に押し上げ

AgenticASRは音声認識とテキスト整形を分離し、新しい音声が入力されるたびに小型のRefinerが既存出力の限られた範囲を書き換えることで、文字起こし全体を繰り返し処理する必要をなくす。コード、チェックポイント、917問の日中バイリンガルベンチマークは公開済みだが、音声の大半は音声合成で生成され、採点もLLMジャッジに依存している。

推論系統

QuantWAMs、世界行動モデルを主に4-bitで動作させ、対象モジュールのメモリ使用量をFP16の29%に削減へ

QuantWAMsは、将来の映像とロボットの行動を同時に生成するモデル向けに、量子化キャリブレーションを、構造、結合目的、閉ループ軌跡という3層の意思決定へと再設計した。2つのモデルのシミュレーション成功率はFP16との差が0.2~0.7パーセントポイントだったが、速度データは特定の演算モジュールのみが対象で、実機での比較も各タスク10回にとどまる。

代理工具

ローカルPCエージェントは推論予算を増やしても必ずしも高精度にならず、履歴画像4枚を境に効果が反転

OSWorldを用いた実験により、ローカルGUIエージェントに少量の画面履歴を追加すると反復操作を大幅に減らせる一方、コンテキストやステップ数をさらに増やしても、主に失敗パターンが変化するだけであることが示された。2段階の計画アーキテクチャも、フォーマット処理と連携のコストにより単一エージェントを下回り、計画を並列に多数生成しても、高額なtokenコストをかけて差の一部を埋めるにとどまった。

代理工具

Qwen-UI-Agent、モバイル・デスクトップ・ブラウザ操作を統合し、長軌跡学習を100ステップ超に拡大

Qwenチームは、モバイル、デスクトップ、Web、DeepSearch環境を横断する統一GUIエージェントを提案し、画面操作とCLIコマンドを同一のアクション空間に統合した。技術報告ではOSWorld-Verifiedで79.5%を達成したとしているが、モデルの重み、訓練データ、完全な軌跡はまだ公開されていない。

代理工具

OSReward、コンピューターエージェントの評価モデルが失敗した軌跡を見逃しがちで、視覚的証拠が判定に与える影響は意外に限定的だと判明

OSRewardは、人手でレビューした1,019件のクロスプラットフォーム軌跡を用いて27種類の視覚言語評価モデルを検証し、主な誤りが未完了のタスクを成功と判定することだと明らかにした。ステップごとのテキストを除くと精度は平均7.2ポイント低下する一方、画面入力の変更による影響は小さく、既存の「視覚評価モデル」がエージェントの自己申告に依存している実態が浮き彫りになった。