 推論系統
WIDE、トークンごとにAttentionとFFNを動的にプルーニングし、LLMデコードをエンドツーエンドで1.55倍高速化
WIDEは動的プルーニングをトークン単位のAttentionヘッドグループとFFNチャネルグループにまで細分化し、prefillとdecodeの両方をサポートする。研究では、スパース率50%でコア層のデコードが最大4.95倍高速化した一方、エンドツーエンドの高速化は1.55倍に縮小したと報告している。
Archive
GitHub 熱門專案、開源工具、框架、runtime 與重要 release。
推論系統
WIDEは動的プルーニングをトークン単位のAttentionヘッドグループとFFNチャネルグループにまで細分化し、prefillとdecodeの両方をサポートする。研究では、スパース率50%でコア層のデコードが最大4.95倍高速化した一方、エンドツーエンドの高速化は1.55倍に縮小したと報告している。
 AI 安全
OWASPの「Agentic Skills Top 10」v1ドラフトが公開レビューを終え、悪意あるスキル、過剰な権限、依存関係の混同、クロスプラットフォーム移植のリスクを10種類の管理項目に整理した。このフレームワークは、スキルをモデルとMCPツールの間に位置する振る舞いのレイヤーとして捉え、権限、出所、完全性を宣言できる共通フォーマットを提案している。
 最新模型
VIDRAFTはPOCKETシリーズの重みを公開し、35Bモデルを最小8.2 GBまで量子化しつつ、各tokenで有効化されるパラメータを約3Bに維持した。モデルはアップストリームのllama.cppをそのまま利用できるが、圧縮手法は公開されておらず、性能と品質を示す根拠も現時点では主に開発チームによるものだ。
 最新模型
ReTokenは、すべての画像tokenを一度にモデルへ入力するのではなく、事前に格納した視覚KV cacheから質問に関連するスパースなブロックを取り出す。バックボーンを凍結し、検索tokenのみを学習する手法は単一のH100で実行できるが、成果は依然として主に2種類の8Bモデルに基づいている。
 基準與基礎設施
MLCommonsはEndpoints v0.7をリリースし、推論テストを固定バッチ方式の提出から、自動審査と継続的な更新に対応するエンドポイント・ベンチマーク基盤へと刷新した。今後追加されるマルチターンのエージェント・ワークロードでは、孤立したリクエストのtokens/sだけでなく、個々のユーザーの進捗速度とシステム全体のスループットを同時に評価する。
 形式驗證與 AI 求解
LeanCSPは、モデルの等価性、対称性の除去、求解結果の検査を、単一のLean 4検証チェーンに統合する。計算コストの高い探索は引き続き外部ソルバーが担うが、誤った証明書からLeanカーネル内で定理を構成することはできない。
 AI 安全
新たなフレームワークは「モデルが導出値を誤って信頼する」問題を、矛盾受容、文脈による誤誘導、誤りの訂正、効用低下などの指標に分解する。PPGによる心調律判定を事例に、訓練時にECGを利用し、デプロイ時にはPPGのみを必要とする信頼度モデルが4つのエンドポイントを改善した。ただし、データと重みはコードとともに公開されていない。
 最新模型
DualG-MRAGは、マクログラフで文書横断推論の経路を探索し、ミクログラフで局所的な画像・テキスト証拠を照合することで、細粒度ノードによる知識グラフの急速な肥大化を防ぐ。MMQAでは、R@5をグラフベースの最良ベースラインの42.1%から61.9%へ向上させたが、コードとインデックス構築コストはまだ公開されていない。
 代理工具
Group-Reflective Self-Distillationは、外部教師から固定スキルを抽出するのではなく、同一方策による成功rolloutと失敗rolloutを比較し、その差分をターン単位の訓練信号へ変換する。3種類のエージェント環境で全体的な改善を達成した一方、訓練時間はGRPOより17%増加し、反省テキストの評価には依然として外部モデルの呼び出しが必要となる。
 GitHub Repo
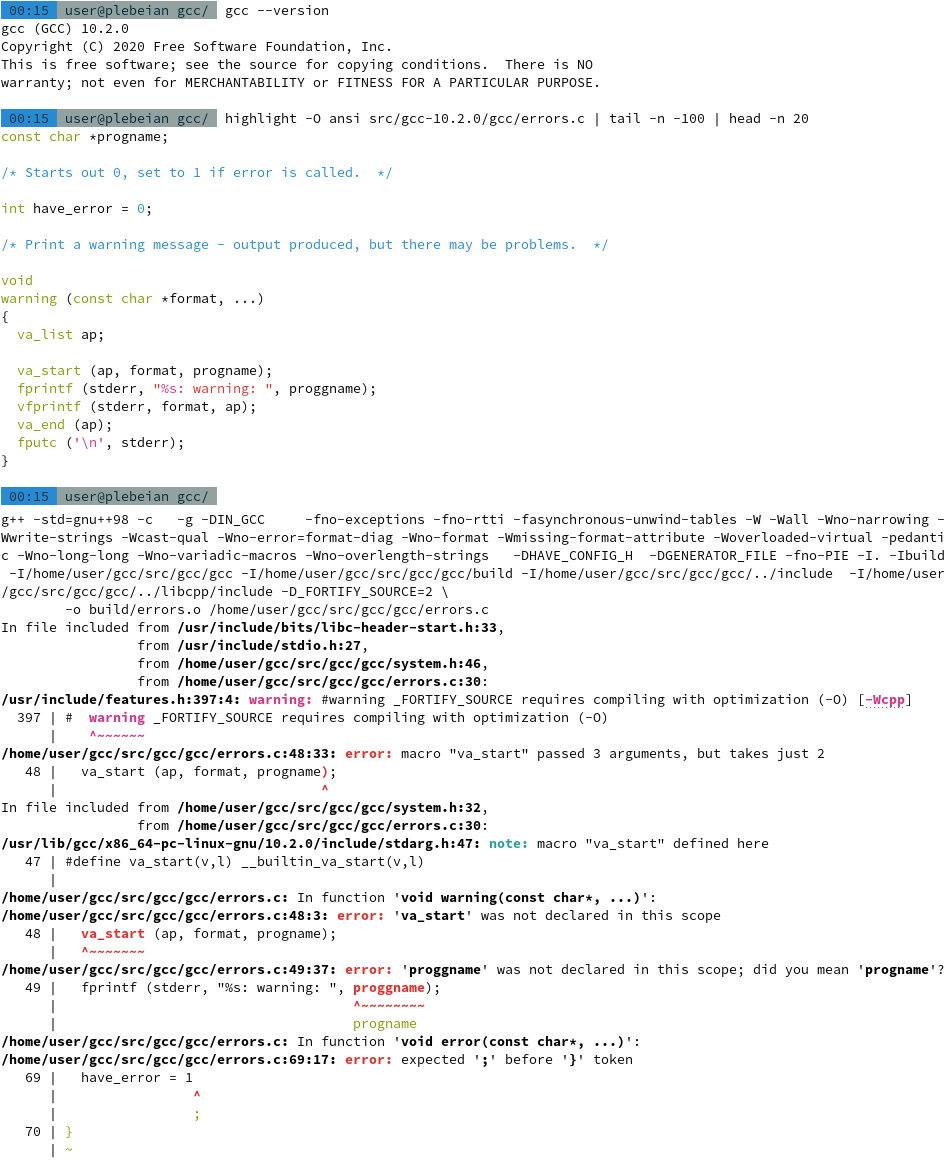
GCC Steering CommitteeはAIによる貢献に関するポリシーを承認し、原則としてLLMの出力を含む、またはその出力から派生した実質的なコードや文章を拒否する。モデルは引き続きデバッグ、分析、レビューに利用でき、メンテナーは生成されたテストを受け入れることもできるが、その出力を通常の貢献に直接含めることはできない。
 代理工具
Change2Taskは、マージ済みPRから開発意図を抽出し、同じリポジトリの現行バージョン上で実行可能なタスクとして再構築する。研究では1,130件の候補変更から900件のタスクセットを生成したが、大半のケースでは再構築に別のコーディングエージェントを必要とした。
 代理工具
MemHarnessは、検索した過去の経験をそのまま再生するのではなく、同じポリシーモデルに現在の状態に照らして批判・再構成させたうえで、行動を決定する。GRPOによるエンドツーエンド学習後、ALFWorldとWebShopでそれぞれ85.2%と75.6%の成功率を達成したが、コードと重みはまだ公開されていない。