 代理工具
StateBridge、閉形式アライメントでエージェント間の隠れ状態を伝送――26組のテスト中22組で単独または同率首位
StateBridgeは直交Procrustes変換を用いて、送信エージェントの最終層の隠れ状態を受信エージェントの入力埋め込み空間へマッピングし、プロジェクターの学習を不要にする。4モデルの平均スコアは最強のベースラインを2.4~2.9ポイント上回ったが、現時点では同一のモデル重みを使用するエージェントのみをサポートする。
Archive
GitHub 熱門專案、開源工具、框架、runtime 與重要 release。
代理工具
StateBridgeは直交Procrustes変換を用いて、送信エージェントの最終層の隠れ状態を受信エージェントの入力埋め込み空間へマッピングし、プロジェクターの学習を不要にする。4モデルの平均スコアは最強のベースラインを2.4~2.9ポイント上回ったが、現時点では同一のモデル重みを使用するエージェントのみをサポートする。
 推論系統
FlashDriveは、視覚エンコーディング、LLM prefill、推論token、軌跡デノイジングという4つのボトルネックを同時に処理し、RTX PRO 6000上でAlpamayo 1.5-10Bの単一ウィンドウ・レイテンシを717ミリ秒から151ミリ秒に短縮した。オープンソース実装はリアルタイム推論に近づいたが、専用のファインチューニングを経ており、クローズドループ評価も100本のシミュレーションクリップに限られる。
 最新模型
AlayaWorldは、インタラクティブ世界モデルの空間メモリと条件付けパイプラインを刷新し、カメラ制御、過去フレーム、生成コンテンツに整合した因果VAE表現を使用するようにした。新たな報告ではWBenchで一貫性の総合スコア首位を記録したが、新版の重みと推論コードはまだ同時公開されていない。
 推論系統
GCacheは、隣接するデノイズステップ間の局所的な類似度で再計算の要否を決めるのではなく、最終的な画質への影響が最小となるキャッシュ再利用シーケンスを探索する。Wan2.1で2.17倍の高速化を維持しながら偏差を大幅に抑えた一方、方策探索には複数のH100が必要で、実装もまだ公開されていない。
 推論系統
vTokenはPagedAttentionのブロック層の上に、トークンから物理位置へのマッピングを追加し、退避後に点在するKVの空き領域を再圧縮する。vLLMのプロトタイプでは保持ブロック数を最大72.3%削減したが、評価は依然として単一ノード・単一GPUと、7B~8B級モデルが中心だ。
 AI 基礎設施與訓練系統
LazyTrainは学習前にactivationの保持、オフロード、再計算の位置を一括決定し、PCIeおよびNVMe転送をGPUの計算ウィンドウ内に収める。Qwen3.6-27Bの実験では性能が176.90から219.95 TFLOPSに向上したが、現時点で検証されているのは単一GPUとオフラインスケジューリングのみだ。
 推論系統
新手法は、数千から1万個の有効な文字列に対してtrieの状態とtoken maskを事前構築し、汎用文法コンパイルにおけるカーディナリティのボトルネックを回避する。著者らの測定では、バッチサイズ256で毎秒219リクエストを処理した。ただし実装はまだ公開されておらず、この数値には既存のguided decoding経路を迂回する統合上の効果も含まれる。
新研究發現,混合線性注意力模型的巨量啟用並非隨機散布,而會在完整注意力層前形成尖峰,並於中間的線性層維持平台。團隊公開分析程式與受控模型,但完整論文圖表所用的逐筆輸入尚未全部釋出。
 代理工具
新たな研究が一般化可能性理論を用いて TheAgentCompany、τ²-bench、AppWorld を分解した結果、エージェントとタスクの交互作用が、エージェント自体の平均的な差を大きく上回ることが分かった。著者らは DDR レポーティング・フレームワークを提案し、選定時にタスク難易度、ホールドアウト検証、コスト、必要サンプル数を併せて報告するよう求めている。
 代理工具
LLNLのチームは、エージェントにFlux、Slurm、Kubernetesなどのリソースを探索させ、高レベルの意図を検証可能なジョブ仕様へ変換した。6つのクラウドクラスターでの実験から、アーキテクチャ、ネットワーク、メモリのmetadataは、実行不能なマシンの除外には主に役立つものの、安定した性能オプティマイザーではないことが示された。
 代理工具
Graph-Structured Rubricsは、評価対象の回答を見る前に、自然言語のrubricを型付きの判定、変換、集約、ゲートノードへコンパイルする。GPT‑OSS‑120Bを用いた実験では、フラットなPrometheus方式の採点を上回ったが、現時点で実装コードは公開されておらず、改善幅もデータセットに大きく依存する。
 最新模型
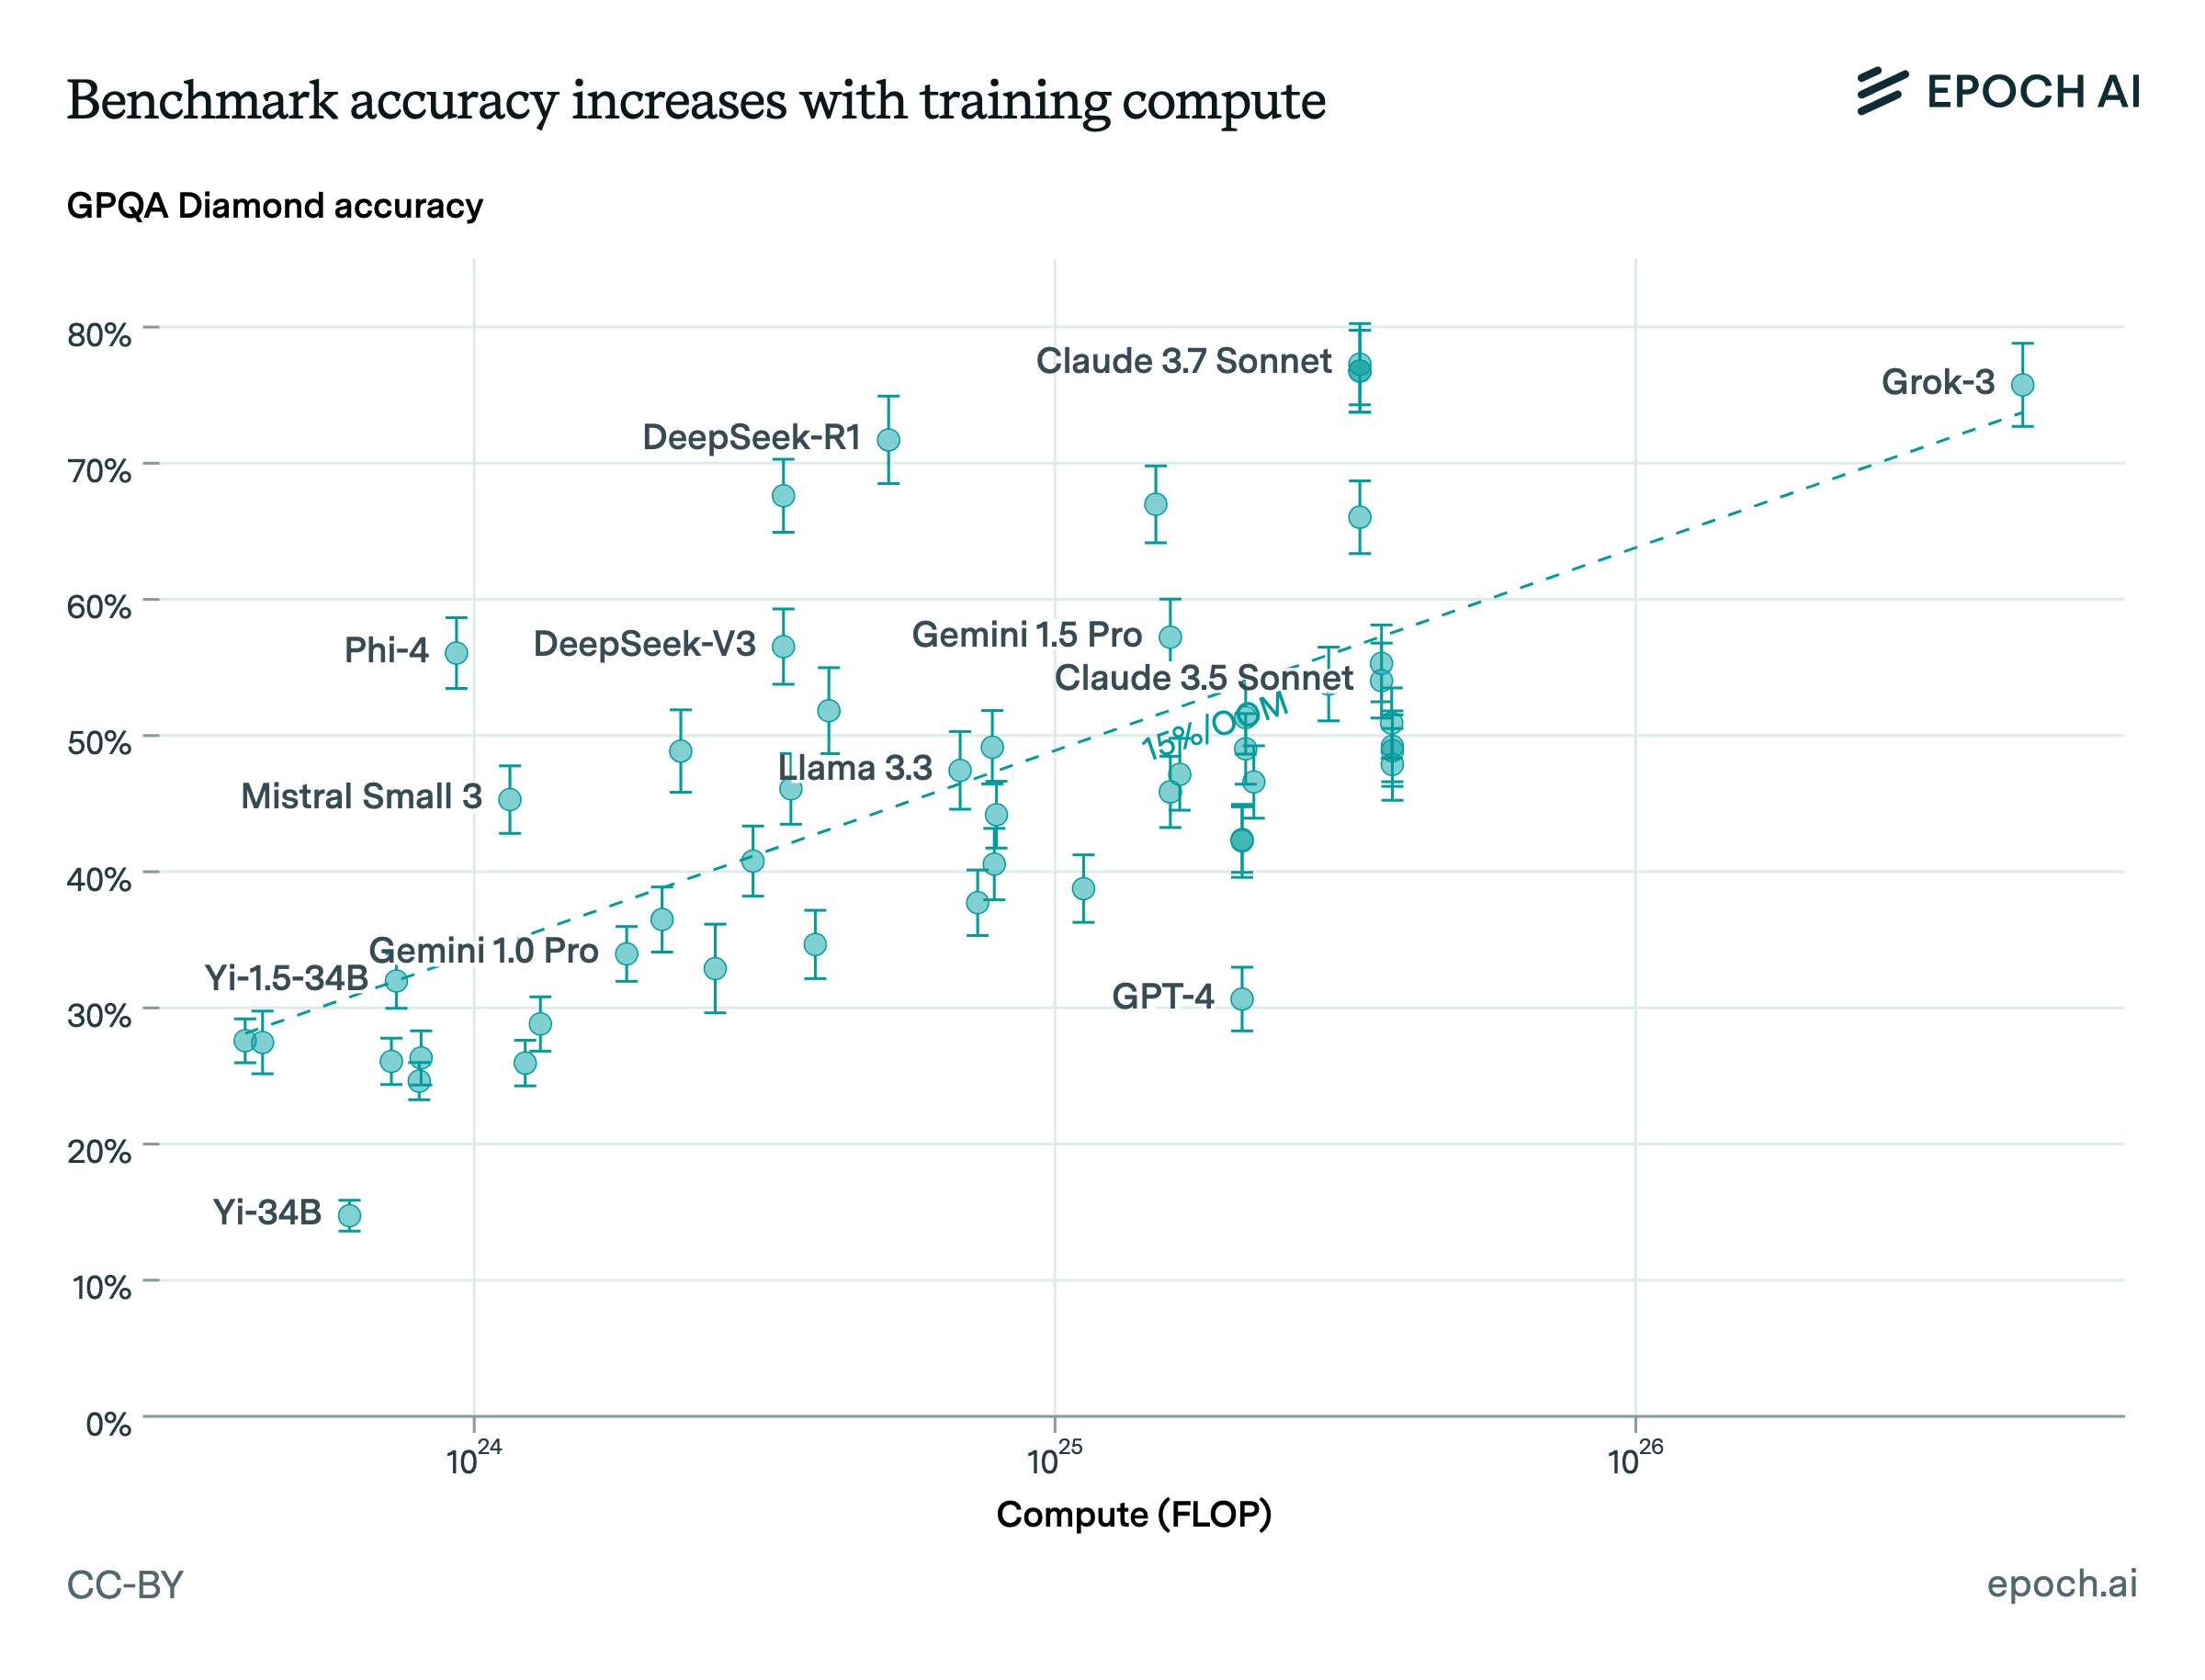
事前登録研究により、Qwen2.5-7BとLlama-3-8Bは、GPQA Diamondの問題の大半で投票数を増やすほど誤答に収束しやすくなることが分かった。全体の平均スコアはなおわずかに上昇しており、集約指標が問題ごとの性能低下を覆い隠すことを示している。