 最新模型
TranslatePsy、アフリカ言語翻訳モデルを公開——0.8B~4B版は量子化してオフライン実行可能
Tether AI Researchは、Qwen3.5をファインチューニングしたAfriSLMと、ブラウザやスマートフォン向けの17M~43MパラメータのAfriNanoをリリースした。モデルは最大19のサハラ以南アフリカ言語に対応するが、大規模ベースラインを上回るとの結論は主に自動評価指標に基づいており、母語話者の専門家による評価はまだ行われていない。
Archive
GitHub 熱門專案、開源工具、框架、runtime 與重要 release。
最新模型
Tether AI Researchは、Qwen3.5をファインチューニングしたAfriSLMと、ブラウザやスマートフォン向けの17M~43MパラメータのAfriNanoをリリースした。モデルは最大19のサハラ以南アフリカ言語に対応するが、大規模ベースラインを上回るとの結論は主に自動評価指標に基づいており、母語話者の専門家による評価はまだ行われていない。
 推論系統
Unslothは、Qwen3.8-Flash-NextとGLM-5.3-FlashでMulti-Token Predictionをデフォルトで有効化し、MLX、マルチGPU、ROCmの各経路も改善した。公式が掲げる「最大2倍」には完全なベンチマークマトリクスが添付されておらず、Qwenの技術文書に記載された低並行時の高速化は1.3~1.7倍となっている。
 代理工具
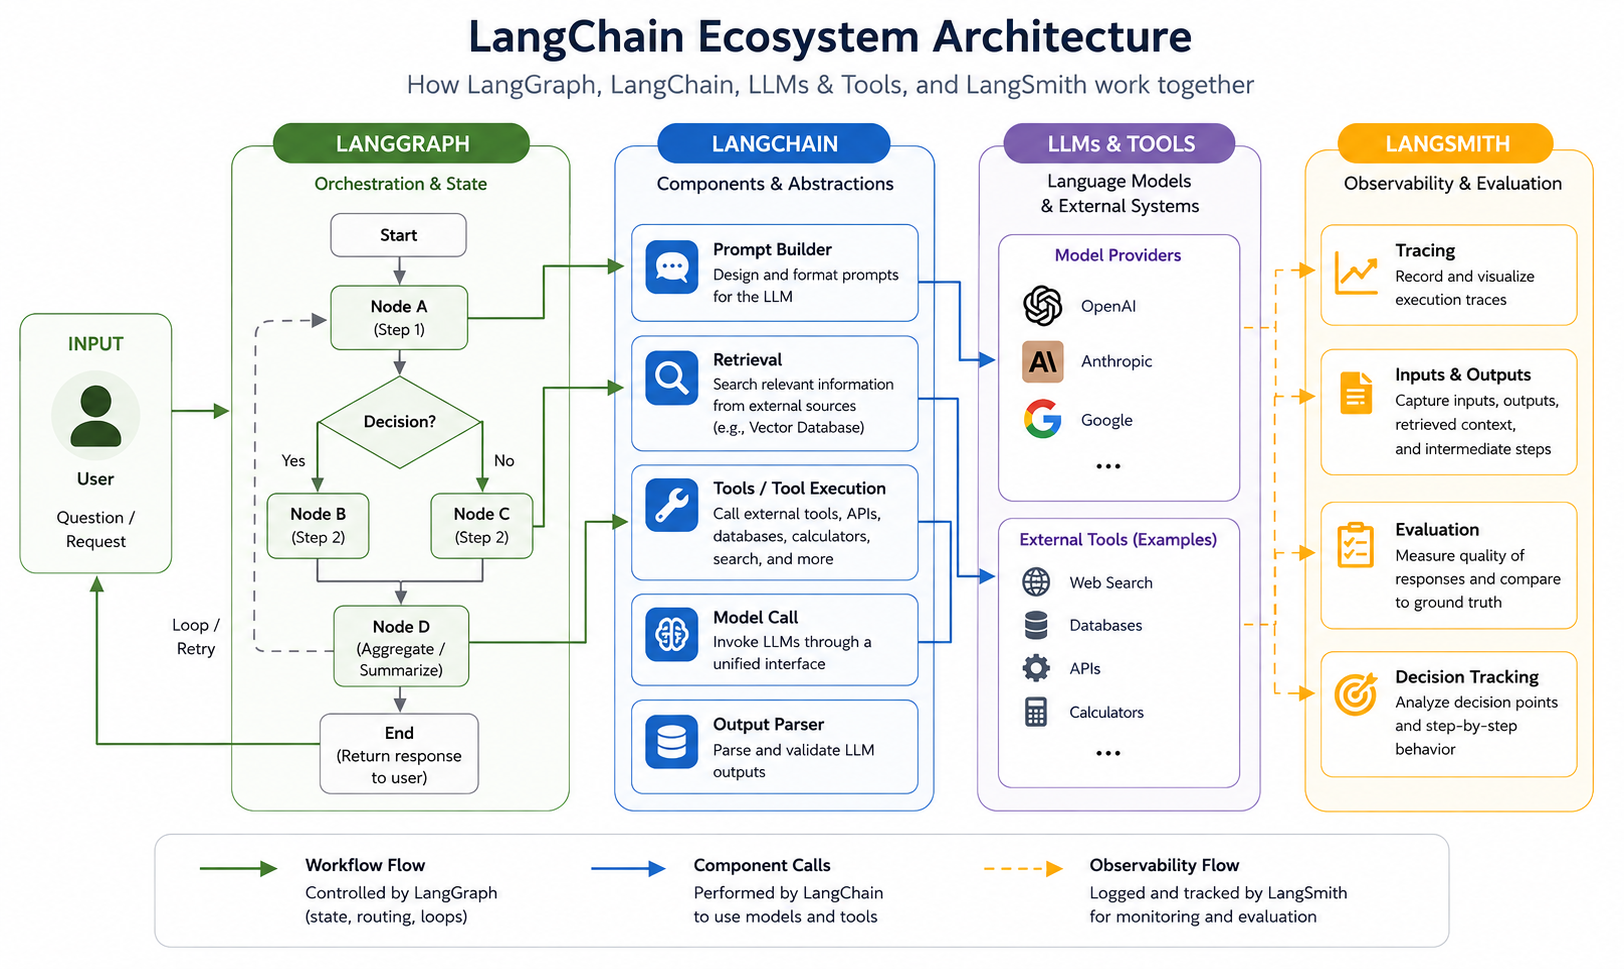
新しい `langchain.mcp` は、単一または複数の MCP サーバーへの接続を統一し、ツール実行途中の問い合わせを再開可能な LangGraph interrupt に変換する。インターフェースは依然として Alpha 段階にあり、連続するバージョンでメソッド名や elicitation の挙動が変更されているため、安定運用が求められる本番環境へ直接導入するのは適切ではない。
 代理工具
GitHubは、Copilotによる、ブランチルールの要件としてカウント可能なApproveレビューの送信を許可するかどうかを管理者が選択できるようにし、パス単位の制限も提供する。この機能は依然としてパブリックプレビュー段階にあり、モデルによる承認を独立した品質保証とみなせるほどの精度を示す証拠もない。
 代理工具
上海人工知能研究所のチームが、既存の coding agent の外側に計画・実装・検証を反復する制御ループを加える Harness-of-Harness を提案した。3ラウンドの実験では平均相対向上率が52.25%に達したが、各条件での生成は1回のみで、実行可能な HoH-lite も依然として「近日公開」とされている。
 代理工具
Clineは、長時間のセッションで状態が更新されるたびに会話ログ全体がブロードキャストされ、Hubのメモリ使用量が数十GBまで膨らむ問題を修正し、状態スナップショットのみを送信するよう変更した。新版ではcheckpoint、サブエージェントのキャンセル、リモートMCP接続の動作も厳格化されたが、モデルを固定していないデプロイでは、デフォルトモデルの大幅な更新によって結果が変わる可能性がある。
 最新模型
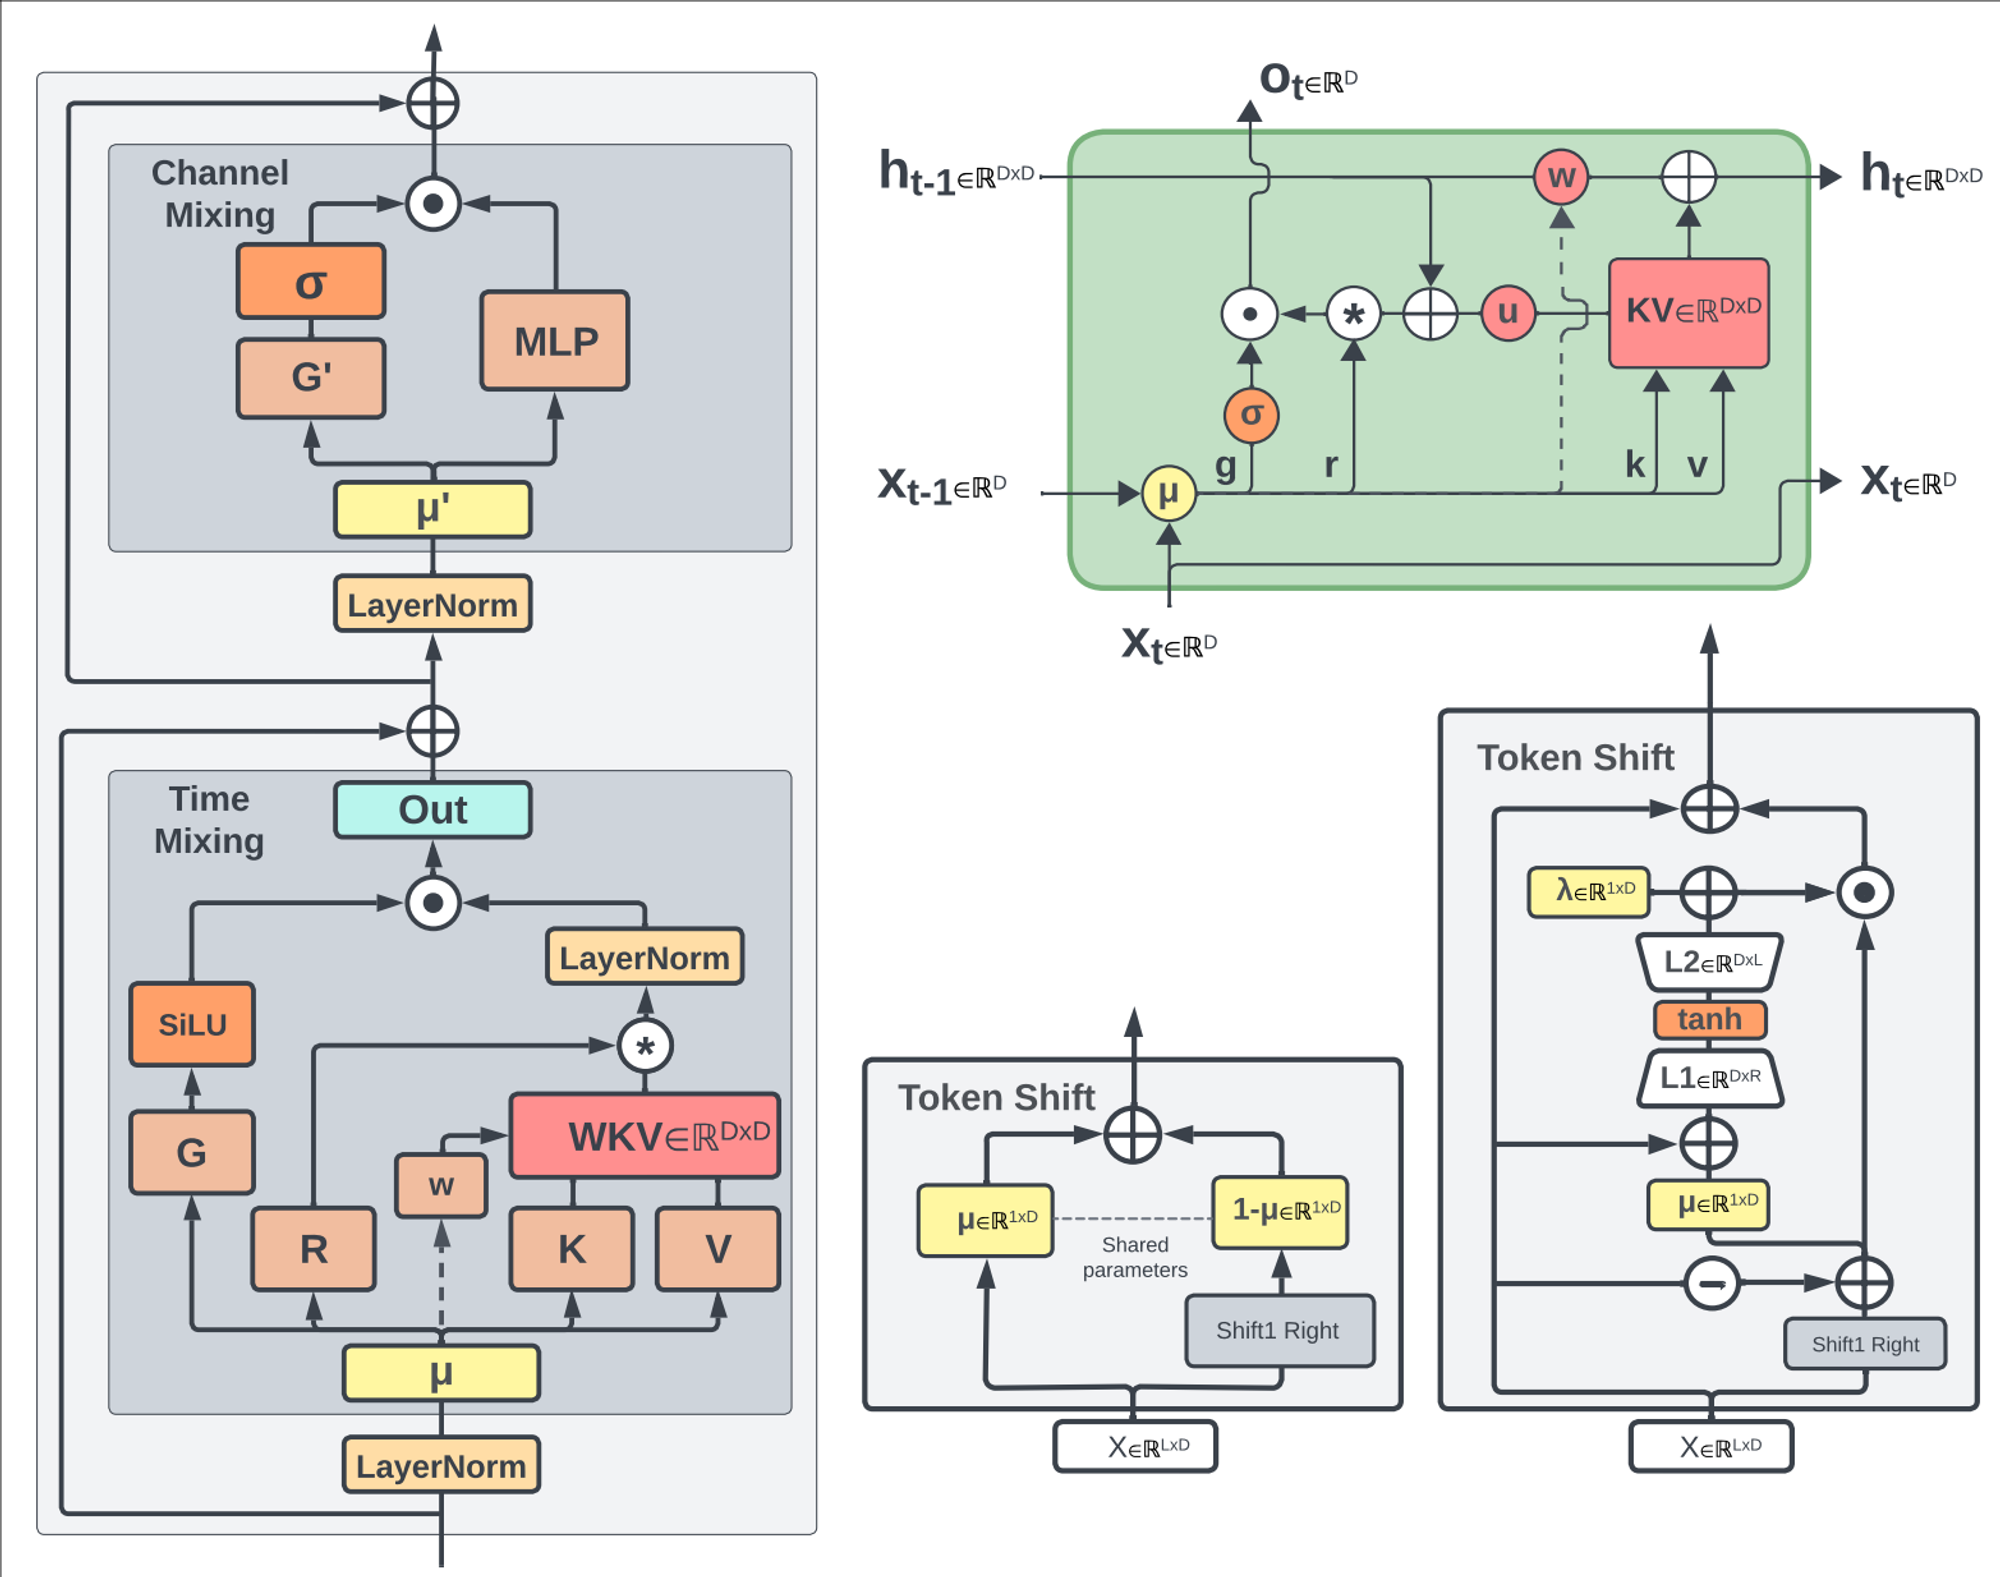
RWKVチームは、13.3BパラメータのG1jベースモデルを公開し、Transformers、LoRA、TileLangによる推論サポートをパッケージ化した。固定サイズの再帰状態により、コンテキストとともに増大するKV cacheを回避できる一方、安全性や能力の評価は示されておらず、成熟したチャットアシスタントと直接みなすことはできない。
 代理工具
MetaはMuse Codeのベータ提供を終了し、セッション間メッセージング、サブエージェント・ワークフロー、確認可能な巻き戻し操作を追加した。同時公開されたTypeScript SDKはMuse Session Protocolを公開するが、互換性が保証されないpre-1.0のDeveloper Preview段階にある。
 最新模型
Google Researchの3億3,000万パラメータのTimesFM-3は、1回のフォワードパスで複数の時系列を共同予測し、過去共変量と既知の将来共変量も取り込める。コードはApache 2.0だが、新版の重みには別途非商用ライセンスが適用されるため、本番デプロイでは旧版と同じ前提を踏襲できない。
 最新模型
Ai2がBenchMIRTをオープンソース化し、3万4,000問超に対するモデルの回答パターンから、安全性や一般推論などの潜在能力を分離した。実験では、一部の安全性ベンチマークが主に推論性能を反映していることや、厳選した約1割の問題でも能力順位をおおむね維持できることが示された。ただし、データの対象は2025年初頭までのモデルに限られる。
 代理工具
新版では、すべての組み込みSeatbeltプロファイルで、Docker、OrbStack、Colimaなどのコンテナランタイムのソケット、実行ファイル、IPCインターフェースをブロックする。書き込みポリシー、safety checker、A2Aのキャンセル状態も修正されたが、カスタムインストールパスや既存のワークフローについては引き続き個別の検証が必要だ。
 推論系統
llama.cppは、Qwen3.8-Flash-Nextでドラフトtokenが拒否された際にSSMと畳み込み状態を正しくロールバックできない問題を修正した。RTX PRO 6000を1基使用したテストでは、コードのデコード性能が123 token/sから183 token/sに向上したが、この結果は特定の量子化方式、ドラフトヘッド、単一ワークスロットに限られる。