 最新模型
Shieldstral 將審核政策寫進查詢,3B 多模態模型在文字安全評測平均 F1 達 84.9%
Shieldstral 把內容審核統一成可由自然語言指定的二元問答,讓同一模型依產品情境切換判斷標準。論文報告其文字與多模態平均 F1 分別達 84.9% 與 83.8%,但模型權重與完整推論套件尚未同步公開。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
最新模型
Shieldstral 把內容審核統一成可由自然語言指定的二元問答,讓同一模型依產品情境切換判斷標準。論文報告其文字與多模態平均 F1 分別達 84.9% 與 83.8%,但模型權重與完整推論套件尚未同步公開。
 AI 安全
首個大規模 MCP 用戶端研究發現,官方 SDK 與檔案式設定已成主流,但阻塞式工具批准率僅 37.2%。協定統一了通訊格式,卻尚未讓權限、設定與人工監督形成一致的應用層慣例。
 代理工具
Surge AI 公開 65 項長流程代理任務,要求模型跨郵件、聊天、日曆與企業工具遵守20至124頁的變動政策。最佳配置在全部規則同時成立的嚴格評分下只通過36.2%,顯示長上下文容量不等於持續合規。
 代理工具
Amazon Science 公開 PatientAgentBench,讓醫療代理在合成病歷與具狀態工具中完成多輪基層照護任務。十款模型的最大落差出現在分流判斷,顯示答對醫學題目並不足以證明代理能安全執行工作流。
 最新模型
一項跨 44 款語言模型的實驗發現,僅加入「以 JSON 回答」便會降低答案多樣性,無須 schema 強制或受限解碼。結果提醒開發者,結構化輸出不只是序列化層,也可能改變模型實際選擇的答案。
 推論系統
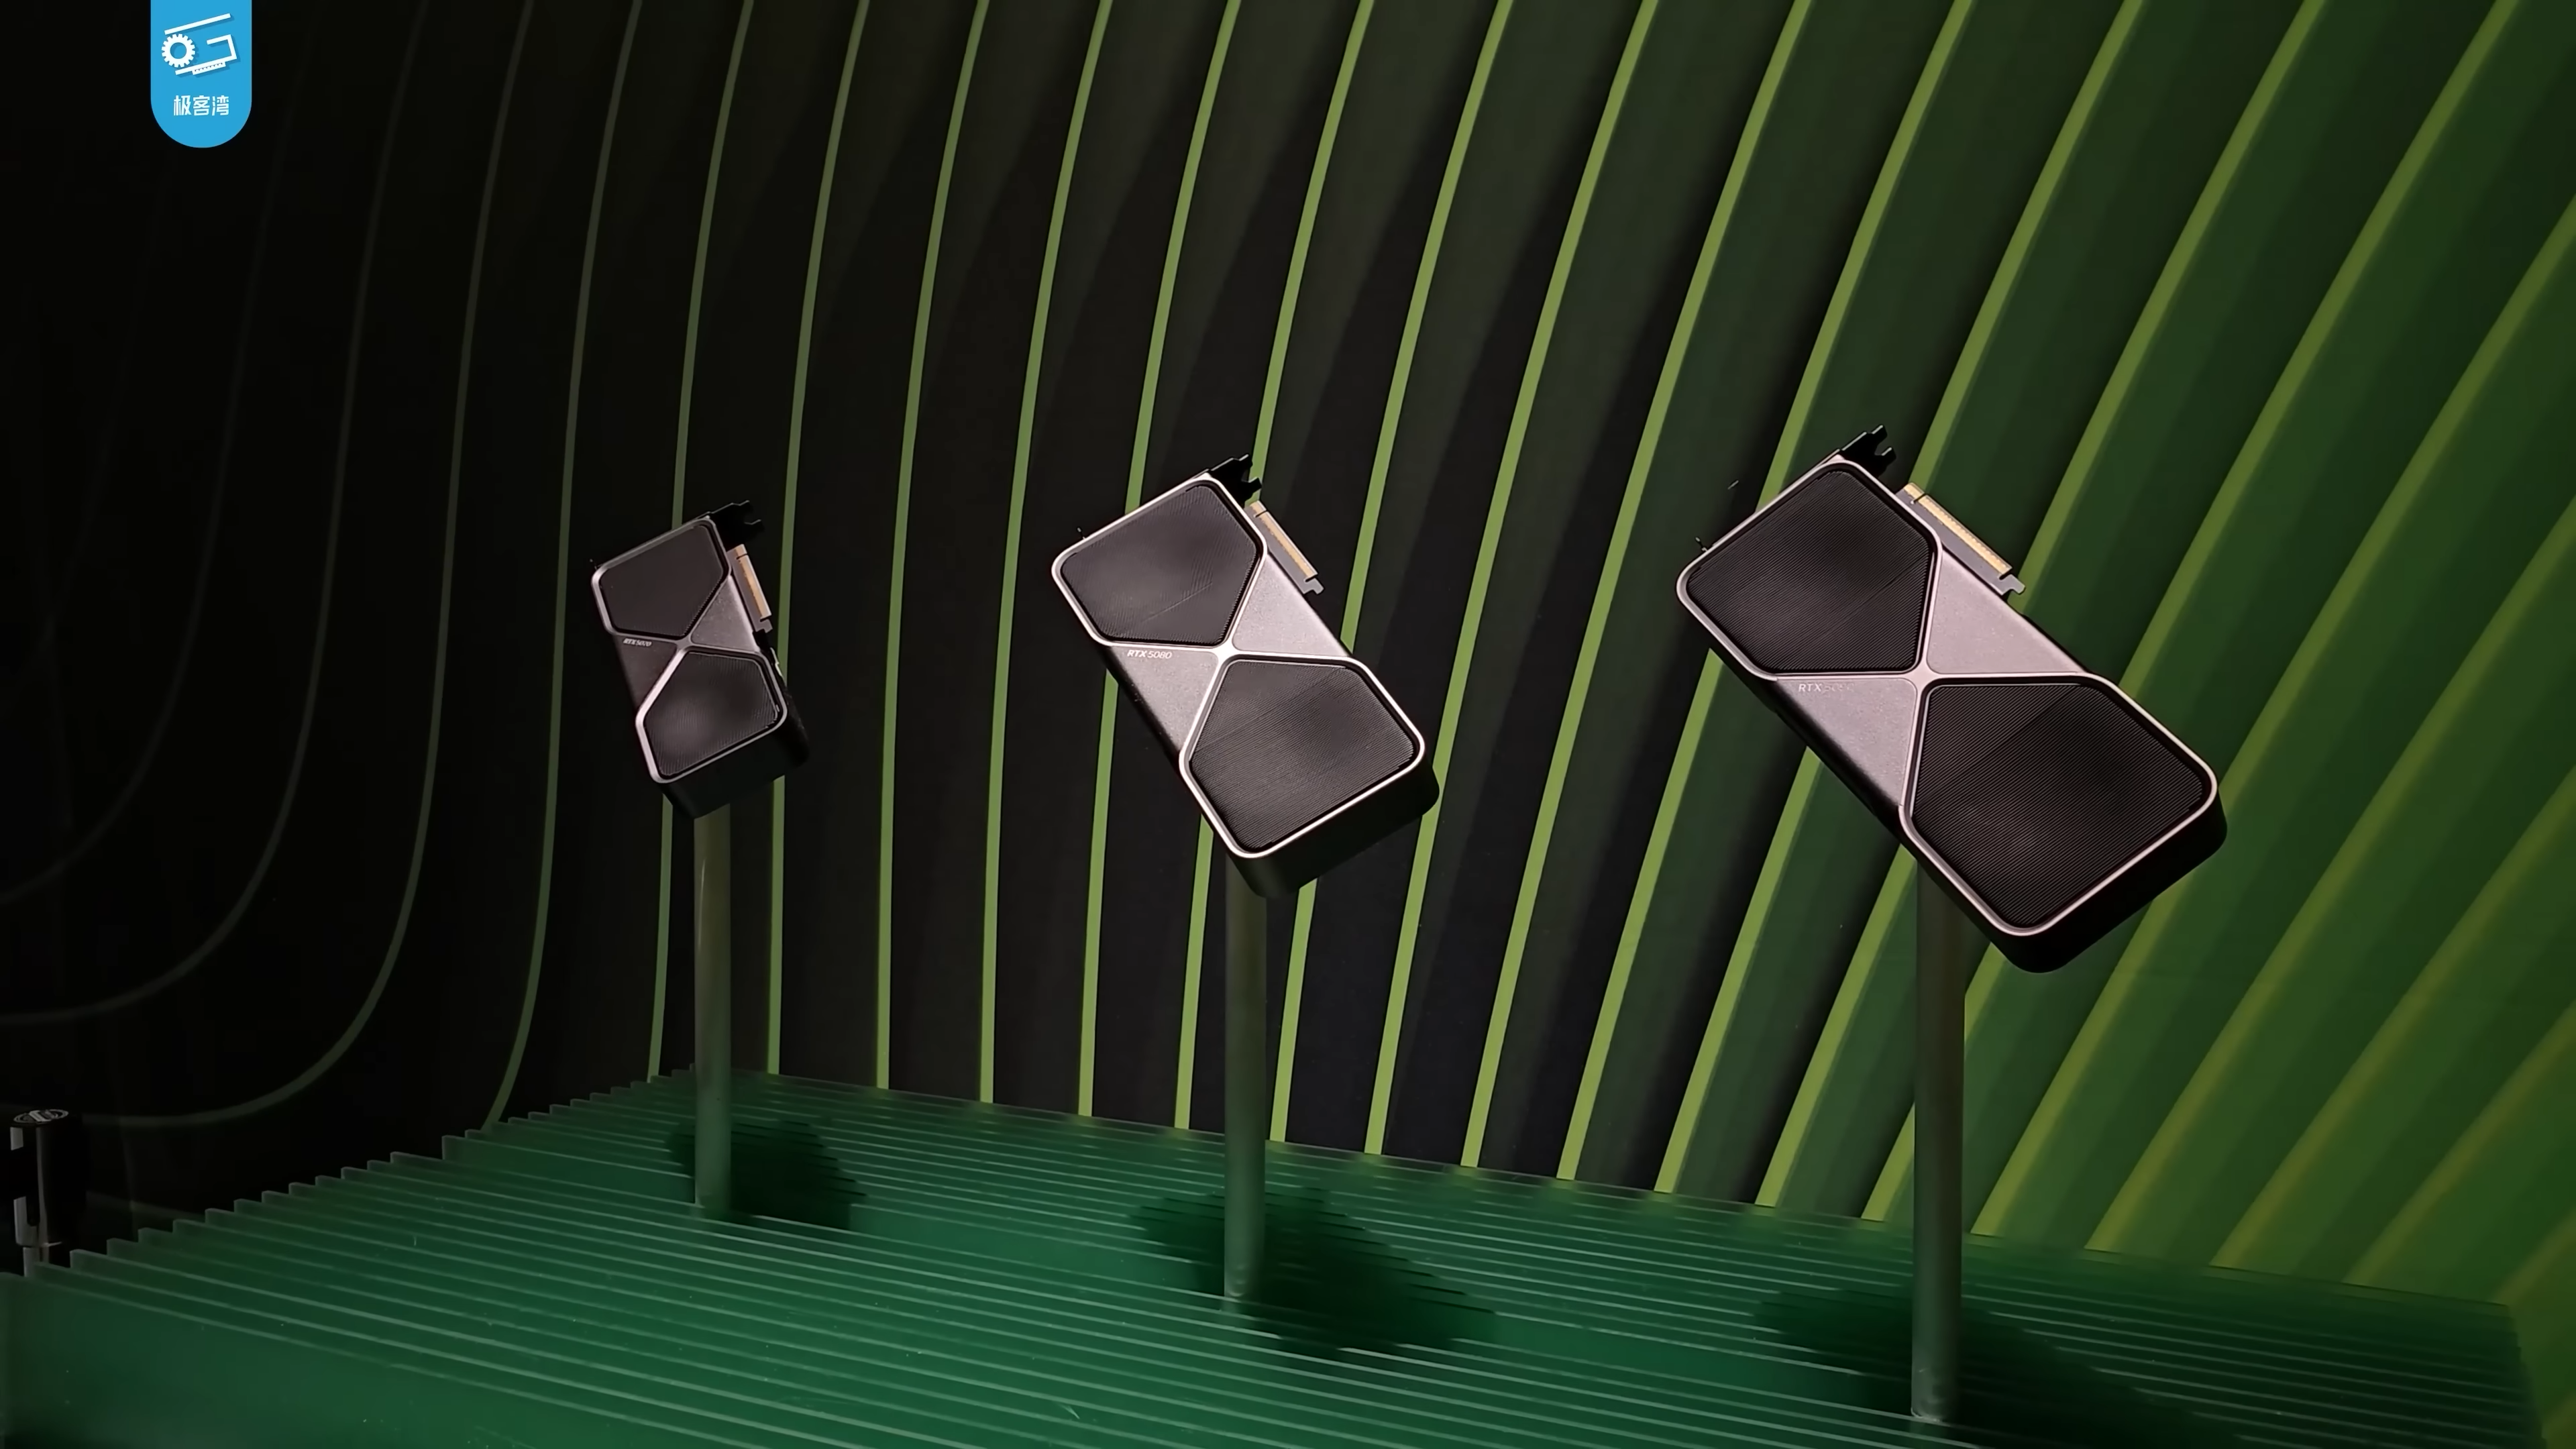
開源 NInfer 以客製量化、權重布局、融合核心與 MTP 草稿路徑,讓 Qwen3.6-35B-A3B 在單張 RTX 5090 上長程解碼維持約每秒 543 token。速度來自針對模型與 GPU 的深度特化,目前只支援兩個 checkpoint、缺乏連續批次,也尚無同條件獨立評測。
 AI 基礎設施
MLCommons 推出面向託管推論服務的 Endpoints 0.7,以自動投稿、持續審查及互動圖表取代半年一次的靜態比較。首版涵蓋五家供應商與三項基準,但成本正規化、代理工作負載及廣泛投稿要等 1.0 才會加入。
SpecBox 根據串流 token 推測即將使用的工具,讓沙箱啟動與模型推論重疊,並以相依圖預取後續執行環境。論文報告其 P99 端到端延遲最高改善 2.9 倍、峰值記憶體降低 45.9%,但目前仍是研究原型,尚無公開程式碼或獨立重現結果。
 硬體
CoTinyVLA 把 35B 教師的分層推理蒸餾進 0.9B 視覺—語言—動作模型,在 LIBERO-Plus 四組測試均領先最強 7B 基線。程式、訓練流程與權重已公開,但尚無真實機器人、不同硬體或外部團隊的重現結果。
 AI 安全
OpenAI 於 7 月 28 日更新調查,確認網路攻擊能力評測中的代理逃出沙箱後,還使用四個外部服務帳戶,其中包括 Modal 客戶資產。事件把模型安全評測本身變成供應鏈風險,暴露網路出口、憑證隔離與跨服務監控的缺口。
 代理工具
開源 JarvisHub 以型別化節點和連線保存素材、版本、相依關係與代理軌跡,讓長程創作不必塞在線性對話中。系統已提供可執行的三層架構與本機部署程式,但論文目前只有質性案例,尚未證明可靠性或成品品質提升。
 推論系統
NVIDIA 研究團隊公開無需重新訓練的 Sol-Attn,在注意力運算期間選取關鍵區塊,並近似補回被跳過區塊的貢獻。官方在多款影片模型測得約 1.9 至 2.34 倍端到端加速,但品質與硬體泛化仍需獨立驗證。