 代理工具
ORCA-bench 重建六天遙測現場,前沿代理的中等難度根因分析最高僅 25.3%
ORCA-bench 以可運行的微服務、50 GB 遙測資料與 1,079 起事故,測試程式代理能否從模糊通報找出根因。即使提供完整原始碼,最佳代理在貼近真實輸入的中等難度任務也只答對四分之一。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
代理工具
ORCA-bench 以可運行的微服務、50 GB 遙測資料與 1,079 起事故,測試程式代理能否從模糊通報找出根因。即使提供完整原始碼,最佳代理在貼近真實輸入的中等難度任務也只答對四分之一。
 最新模型
Mistral 的夏季模型清理進入最後一批,涉及 Devstral、Magistral、Mistral Small 與 Open Mistral Nemo 等舊版識別碼。官方替代模型並非同架構快照,遷移不能只改名稱,還要重新驗證工具呼叫、輸出 schema、上下文與成本。
 基準與基礎設施
MLCommons 發布 Endpoints v0.7,把推論測試從固定批次提交改造成可自動審核、持續更新的端點基準基礎設施。即將納入的多輪代理負載會同時衡量單一使用者進度與整體吞吐量,而非只計算孤立請求的 tokens/s。
 最新模型
DeepSeek 將重新後訓練的 V4-Flash 推入 API 公測,模型架構、284B 總參數與 13B 啟用參數均未改變。新版原生支援 Responses API,主打程式代理與工具使用,但關鍵測試依賴尚未公開的 DeepSeek Harness。
 RAG 與檢索系統
GLM-RAG 讓節點、關係與問題在第一層注意力便共同互動,而非只靠圖距離傳播訊息。它在未見領域的多跳評測取得較佳結果,但單跳任務仍由普通向量 RAG 領先,程式與模型也尚未公開。
 AI 安全
新框架把「模型誤信衍生數值」拆成衝突接受、情境誤導、錯誤修復與效用損害等指標。以 PPG 心律判讀為案例,訓練時借用 ECG、部署時只需 PPG 的可靠度模型改善四項端點,但資料與權重未隨程式碼公開。
 最新模型
DualG-MRAG 以巨觀圖尋找跨文件推理路徑,再用微觀圖核對局部影像與文字證據,避免細粒度節點使知識圖快速膨脹。研究在 MMQA 將 R@5 從最佳圖式基線的 42.1% 提高至 61.9%,但尚未公開程式碼與索引建置成本。
 代理工具
Group-Reflective Self-Distillation 不再從外部教師擷取固定技能,而是比較同一策略成功與失敗的 rollout,再把差異轉成逐回合訓練訊號。它在三種代理環境取得整體改善,但訓練時間較 GRPO 增加 17%,且仍須呼叫外部模型評分反思文字。
 GitHub Repo
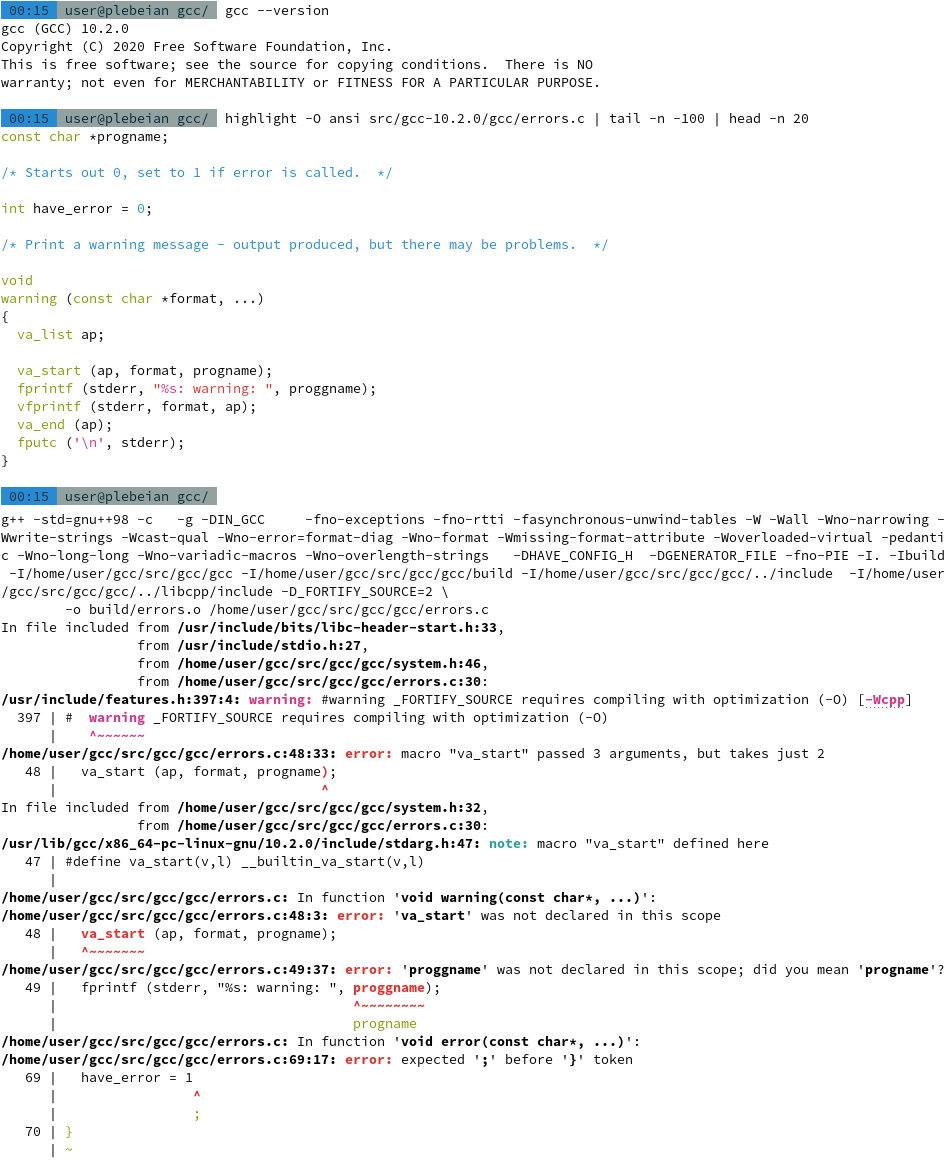
GCC 指導委員會通過 AI 貢獻政策,原則上拒絕包含或衍生自 LLM 輸出的重大程式碼與文字。模型仍可用於除錯、分析與審查,維護者也可接受生成測試,但輸出不可直接進入一般貢獻。
 代理工具
Change2Task 從已合併 PR 提取開發意圖,再於同一儲存庫的現代版本重建可執行任務。研究在 1,130 個候選變更中產生 900 組任務,但多數案例仍須依賴另一個程式代理完成重建。
 代理工具
MemHarness 不再原樣回放檢索到的歷史經驗,而是讓同一策略模型依目前狀態先批判、重組,再決定行動。以 GRPO 端到端訓練後,它在 ALFWorld 與 WebShop 分別取得 85.2% 與 75.6% 成功率,但程式與權重尚未公開。
 LLMOps
Grafana 將內部使用的代理觀測平台推向正式可用,並公開支援五種語言及多款代理框架的 agento11y SDK。平台把對話、工具執行、成本、OTel traces、線上評分與離線實驗接入同一套回歸流程,但完整產品仍綁定 Grafana Cloud。