 AI 安全
CompoSkill 顯示逐件通過掃描的代理技能,串接後仍可形成八成風險鏈
CompoSkill 把技能安全從單一套件判定改寫成跨技能資料流與副作用的路徑問題。其 1,140 筆測試中,白箱及黑箱攻擊形成風險鏈的最高比例分別達 83.3% 與 80.6%,但這不等同真實入侵成功率。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
AI 安全
CompoSkill 把技能安全從單一套件判定改寫成跨技能資料流與副作用的路徑問題。其 1,140 筆測試中,白箱及黑箱攻擊形成風險鏈的最高比例分別達 83.3% 與 80.6%,但這不等同真實入侵成功率。
 代理工具
ClawGym II 不改動代理框架內部,而是在模型服務邊界攔截呼叫,再以 prefix tree 還原多輪軌跡。Qwen3-30A3B 經訓練後,在 OpenClaw 與 Claude Code 執行 ClawGym-Bench 的 Pass@1 分別增加 9.98 與 14.81 個百分點。
 AI 安全
新研究發現,多款 guard model 與 activation probe 刪除、打亂或替換規則後,判斷準確率幾乎不變。專為排除文字捷徑而建的交叉測試中,快速偵測器接近隨機,只有逐步推理模型明顯恢復規則與情境的組合能力。
 代理工具
史丹福團隊模擬逾一萬個語言模型代理社群,發現多輪通訊會令弱意見逐步形成共識或極化。研究以擴充 Ising 模型預測未見通訊圖上的個體軌跡,但政治題亦出現向右偏移,顯示協作不必然消除模型偏誤。
 AI 安全
JailbreakSkill 以統一介面封裝提示改寫、失敗分析及技能演化,讓紅隊代理從未成功的攻擊軌跡產生新程序。第二階段令 AdvBench 與 HarmBench 的跨模型平均攻擊成功率分別再升 17.5 及 13.4 個百分點,但評分依賴 GPT-4o 裁判。
 推論系統
ParaTempo 定期探測各條推理路徑的暫定答案分布,據此獨立執行裁切、提前退休及分叉。Qwen3.5-35B-A3B 的四項評測平均準確率較固定 16 路 self-consistency 低 1.1 個百分點,但延遲與生成 token 分別減少 21.8% 及 30.3%。
 代理工具
PACE-Bench 用 144 組可執行物理環境,測試代理能否修正曾經成功、但在摩擦力或材料限制改變後失效的程式設計。實驗顯示反思優於未驗證自我修訂,而長期記憶反會把較強模型綁在早期方案。
CForce 沿用擴散語言模型自己的生成軌跡,把後期較完整的預測蒸餾回早期遮罩狀態。LLaDA2.1-mini 在提高平行解碼量的同時維持準確度,但證據目前集中於同一模型家族與作者控制的評測。
 最新模型
sMuon 先把完整權重的正交化方向投影至 LoRA 因子可表達的低秩空間,再以純矩陣乘法計算更新。方法在 ReLoRA 實驗追平 Riemannion 的最低驗證損失,但跨模型微調結果顯著依賴基礎模型原先使用的最佳化器。
 代理工具
ScienceFlow 不只保存對話摘要,而是把程式、驗證證據、資源紀錄與工作區快照封裝成可恢復階段。官方在完整 MLE-bench 報告 70.22% Any-Medal 率,但跨系統比較仍受模型、硬體與時間預算差異影響。
 最新模型
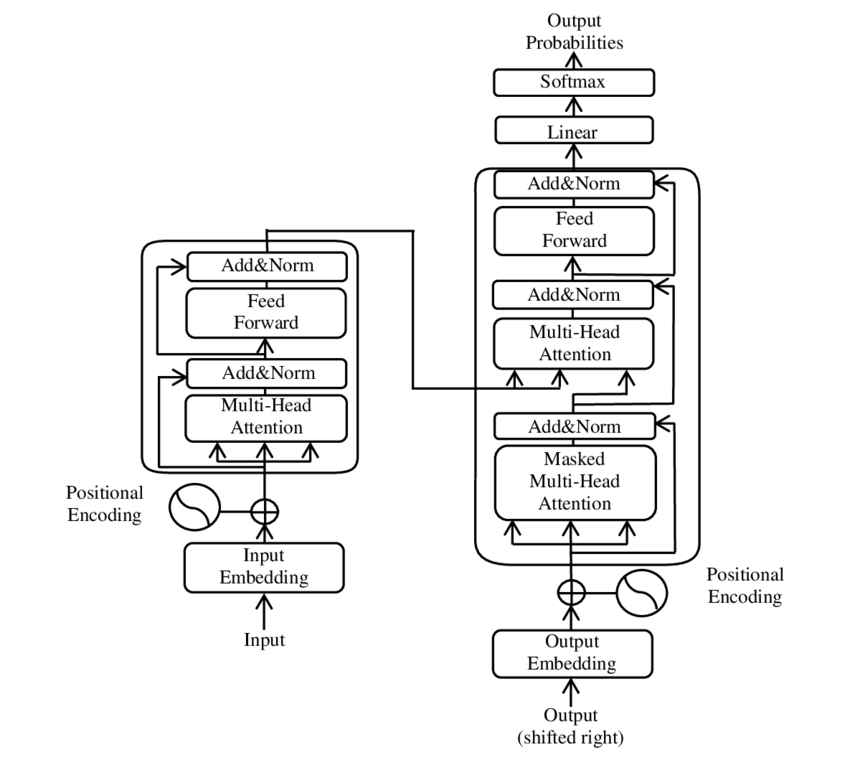
Intern-S2-Mobius 把傳統 Transformer 各層綁定的知識儲存與注意力推理拆開,讓多個 Reasoner 反覆查詢同一組全域 Memory。開放權重可由 LMDeploy、vLLM 或 Transformers 載入,但近 4 倍加速仍是官方特定評測結果。
 最新模型
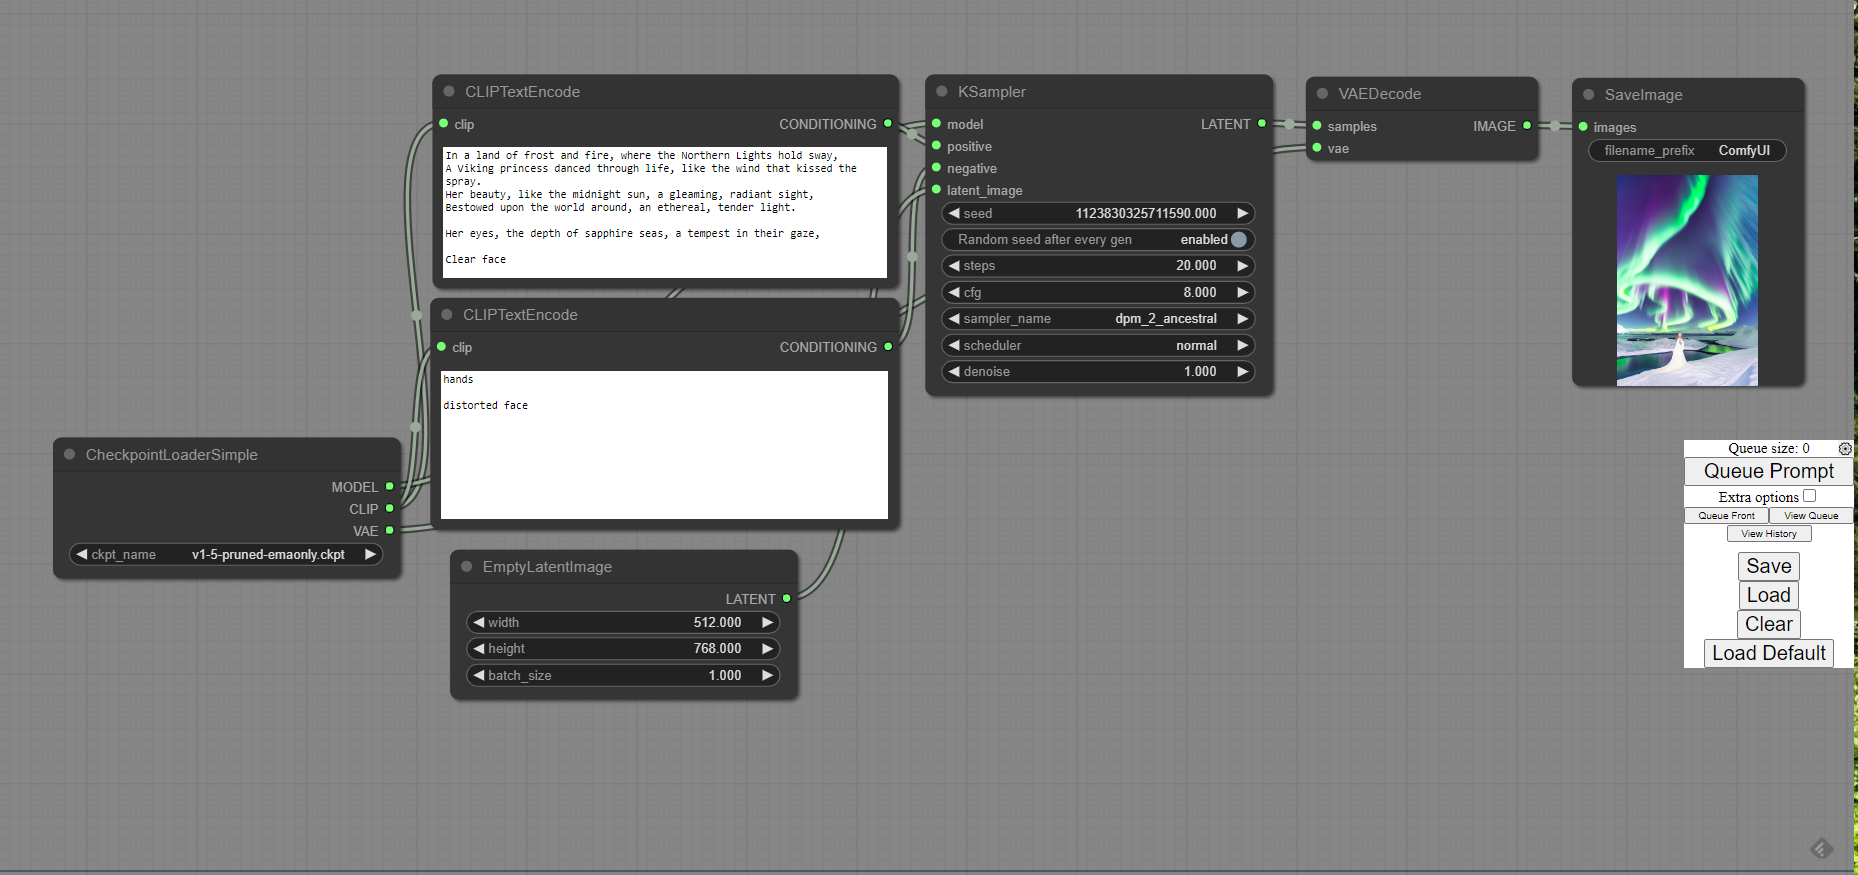
社群為影片模型 MiniMax H3 訓練 5.21GB 單幀 VAE,讓 reference-to-video 管線只生成一幀即可執行換裝、改姿勢與視角變換。方法展示影片模型可被重用為影像編輯器,但目前依賴非官方權重、特定工作流及尚未完全落地的 ComfyUI 單幀介面。