 推論系統
SemPIC、文書を並べ替え可能なKVキャッシュへ事前コンパイル――長文コンテキストタスクの平均F1は完全な再計算に迫る
SemPICは独立したWriterモデルを用い、入力位置に依存しない文書KVをオフライン生成する一方、Readerでは元のモデルと標準キャッシュインターフェースを維持する。3モデル・4タスクの平均micro-F1は既存手法の0.53から0.60へ向上したが、エンドツーエンドのレイテンシ、キャッシュ容量、コードはまだ公開されていない。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
推論系統
SemPICは独立したWriterモデルを用い、入力位置に依存しない文書KVをオフライン生成する一方、Readerでは元のモデルと標準キャッシュインターフェースを維持する。3モデル・4タスクの平均micro-F1は既存手法の0.53から0.60へ向上したが、エンドツーエンドのレイテンシ、キャッシュ容量、コードはまだ公開されていない。
 推論系統
QuantWAMsは、将来の映像とロボットの行動を同時に生成するモデル向けに、量子化キャリブレーションを、構造、結合目的、閉ループ軌跡という3層の意思決定へと再設計した。2つのモデルのシミュレーション成功率はFP16との差が0.2~0.7パーセントポイントだったが、速度データは特定の演算モジュールのみが対象で、実機での比較も各タスク10回にとどまる。
 代理工具
OSWorldを用いた実験により、ローカルGUIエージェントに少量の画面履歴を追加すると反復操作を大幅に減らせる一方、コンテキストやステップ数をさらに増やしても、主に失敗パターンが変化するだけであることが示された。2段階の計画アーキテクチャも、フォーマット処理と連携のコストにより単一エージェントを下回り、計画を並列に多数生成しても、高額なtokenコストをかけて差の一部を埋めるにとどまった。
 AI 安全
AISPAはシステムプロンプトをユーザーの権利に関する8つの観点に分け、商用AI 88製品に含まれる3,249件の指示を監査した。製品の98.9%には少なくとも1つの保護ルールがあったが、全観点を網羅した製品は24%にとどまり、約4割には問題があると判定された指示も存在した。
 代理工具
Qwenチームは、モバイル、デスクトップ、Web、DeepSearch環境を横断する統一GUIエージェントを提案し、画面操作とCLIコマンドを同一のアクション空間に統合した。技術報告ではOSWorld-Verifiedで79.5%を達成したとしているが、モデルの重み、訓練データ、完全な軌跡はまだ公開されていない。
 代理工具
OSRewardは、人手でレビューした1,019件のクロスプラットフォーム軌跡を用いて27種類の視覚言語評価モデルを検証し、主な誤りが未完了のタスクを成功と判定することだと明らかにした。ステップごとのテキストを除くと精度は平均7.2ポイント低下する一方、画面入力の変更による影響は小さく、既存の「視覚評価モデル」がエージェントの自己申告に依存している実態が浮き彫りになった。
 代理工具
Tychoは未知のゲームルールを実行可能な状態遷移モデルとして記述し、検証結果に基づいてモデルを修正するか、迂回するかを判断する。ある公開セットでのテストでは、GPT-5.6 SolとClaude Opus 5が全183レベルをクリアしたが、結果は依然としてフロンティアAPI、単一回の実行、公開問題に大きく依存している。
 代理工具
MicrosoftのEchoverseは、大量の表層的なWebサイト複製を追求するのではなく、データベース状態、因果的な結果、検証可能なタスクを備えた合成アプリケーションを構築する。12の環境で訓練した結果、9Bモデルは14のテスト分割全体で36.5%から67.1%に向上したが、公開版に含まれるのはそのうち4環境のみだ。
 代理工具
新版MCPでは、プロトコルバージョン、ケイパビリティ、クライアント情報を各リクエストに含め、`initialize`ハンドシェイクと`Mcp-Session-Id`を廃止する。水平スケーリングを簡素化できる一方、クライアント、サーバー、ゲートウェイルールを同時に更新する必要がある破壊的変更だ。
 最新模型
Moonshot AIは、42の既存ベンチマークにおける最初の失敗点から知覚能力の分類体系を構築し、3,000問の短答式問題によって10の基本的な視覚能力を切り分けた。その結果、総合スコアが近いモデルでも知覚上の弱点がまったく異なり得ることが示された。一方、テストセットはより大規模な社内問題プールから抽出されており、データ汚染と評価者バイアスには引き続き注意が必要だ。
 代理工具
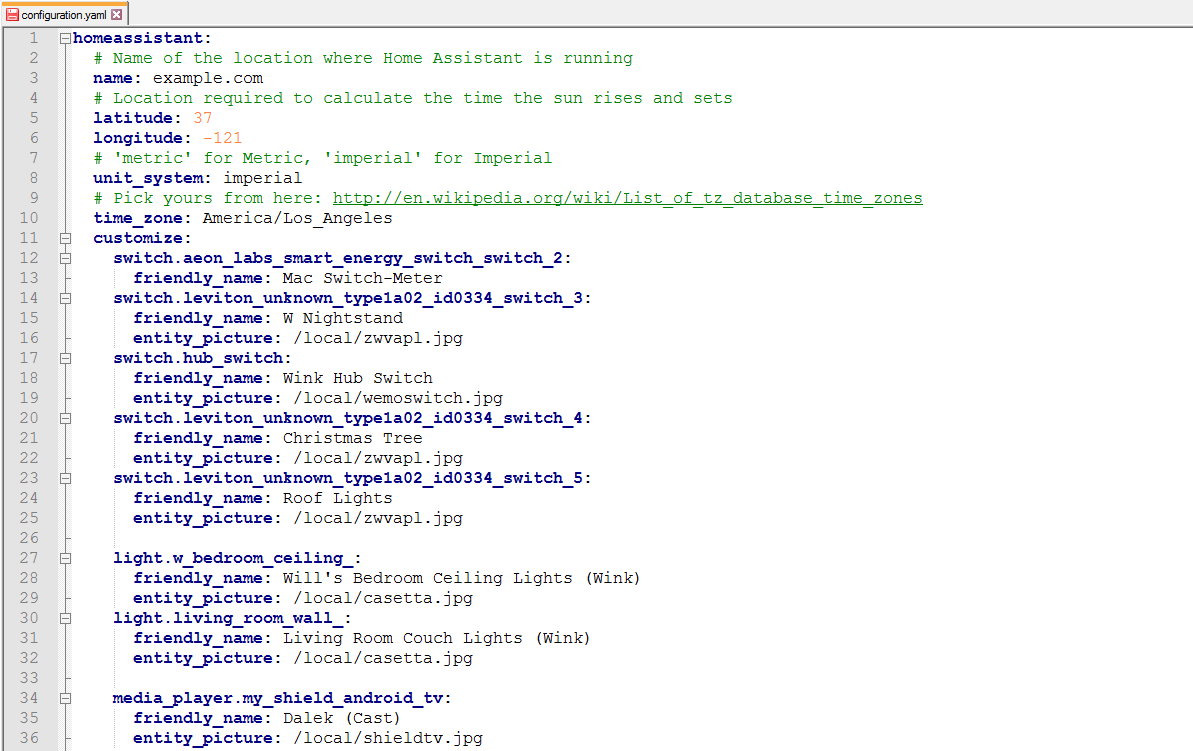
Home Assistantにllama.cppとLiteLLMの会話統合が追加され、モデルごとに個別のエージェントと指示を設定できるようになった。今回の更新でローカルモデル導入のハードルは下がるが、現時点ではまだbetaであり、エンドツーエンドのtool callingの信頼性はモデル、schema、ハードウェアに左右される。
 代理工具
MemChainはベクトル検索の結果をそのまま言語モデルに渡すのではなく、まず計画・順位付け・圧縮を行い、出典に基づくアクティブメモリへ変換する。研究ではLoCoMoとLongMemEval-Sで最先端の結果を報告しているが、完全なコードや実環境でのレイテンシーコストはまだ公開されていない。