 AI 安全
5つのオープンウェイトモデルの自己申告信頼度はほぼ一定、低信頼度優先の監査はランダム抽出と同等の可能性
新たな研究は、限られた人的予算でエージェント群の監査をシミュレーションし、自己申告信頼度の歪みによってランキング戦略がランダム抽出を下回る臨界点を特定した。5つの小・中規模オープンウェイトモデルでは、2つのベンチマークにおける信頼度のAUROCが約0.5にとどまったが、この結論は単一のプロンプトと直接回答という設定に基づく。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
AI 安全
新たな研究は、限られた人的予算でエージェント群の監査をシミュレーションし、自己申告信頼度の歪みによってランキング戦略がランダム抽出を下回る臨界点を特定した。5つの小・中規模オープンウェイトモデルでは、2つのベンチマークにおける信頼度のAUROCが約0.5にとどまったが、この結論は単一のプロンプトと直接回答という設定に基づく。
 代理工具
ORCA-benchは、実行可能なマイクロサービス、50 GBのテレメトリデータ、1,079件のインシデントを用い、コーディングエージェントが曖昧な報告から根本原因を特定できるかを検証した。完全なソースコードが与えられても、最良のエージェントが、実環境に近い入力を使う中難度タスクで正解できたのは約4分の1にとどまった。
 最新模型
Mistralによる夏季のモデル整理が最終段階に入り、Devstral、Magistral、Mistral Small、Open Mistral Nemoなどの旧バージョン識別子が対象となる。公式の代替モデルは同一アーキテクチャのスナップショットではないため、移行時には名前を変更するだけでなく、ツール呼び出し、出力schema、コンテキスト、コストを改めて検証する必要がある。
 基準與基礎設施
MLCommonsはEndpoints v0.7をリリースし、推論テストを固定バッチ方式の提出から、自動審査と継続的な更新に対応するエンドポイント・ベンチマーク基盤へと刷新した。今後追加されるマルチターンのエージェント・ワークロードでは、孤立したリクエストのtokens/sだけでなく、個々のユーザーの進捗速度とシステム全体のスループットを同時に評価する。
 最新模型
DeepSeekは、後学習をやり直したV4-FlashをAPIのパブリックベータとして提供開始した。モデルアーキテクチャ、総パラメータ数284B、アクティブパラメータ数13Bはいずれも変更されていない。新版はResponses APIをネイティブサポートし、コーディングエージェントとツール利用を重視しているが、主要な評価は未公開のDeepSeek Harnessに依存している。
 RAG 與檢索系統
GLM-RAGでは、グラフ距離だけに基づいて情報を伝播するのではなく、ノード、関係、質問が第1層のAttentionから相互作用する。未知ドメインのマルチホップ評価ではより良い結果を達成したが、シングルホップタスクでは依然として通常のベクトルRAGが優位で、コードとモデルもまだ公開されていない。
 AI 安全
新たなフレームワークは「モデルが導出値を誤って信頼する」問題を、矛盾受容、文脈による誤誘導、誤りの訂正、効用低下などの指標に分解する。PPGによる心調律判定を事例に、訓練時にECGを利用し、デプロイ時にはPPGのみを必要とする信頼度モデルが4つのエンドポイントを改善した。ただし、データと重みはコードとともに公開されていない。
 最新模型
DualG-MRAGは、マクログラフで文書横断推論の経路を探索し、ミクログラフで局所的な画像・テキスト証拠を照合することで、細粒度ノードによる知識グラフの急速な肥大化を防ぐ。MMQAでは、R@5をグラフベースの最良ベースラインの42.1%から61.9%へ向上させたが、コードとインデックス構築コストはまだ公開されていない。
 代理工具
Group-Reflective Self-Distillationは、外部教師から固定スキルを抽出するのではなく、同一方策による成功rolloutと失敗rolloutを比較し、その差分をターン単位の訓練信号へ変換する。3種類のエージェント環境で全体的な改善を達成した一方、訓練時間はGRPOより17%増加し、反省テキストの評価には依然として外部モデルの呼び出しが必要となる。
 GitHub Repo
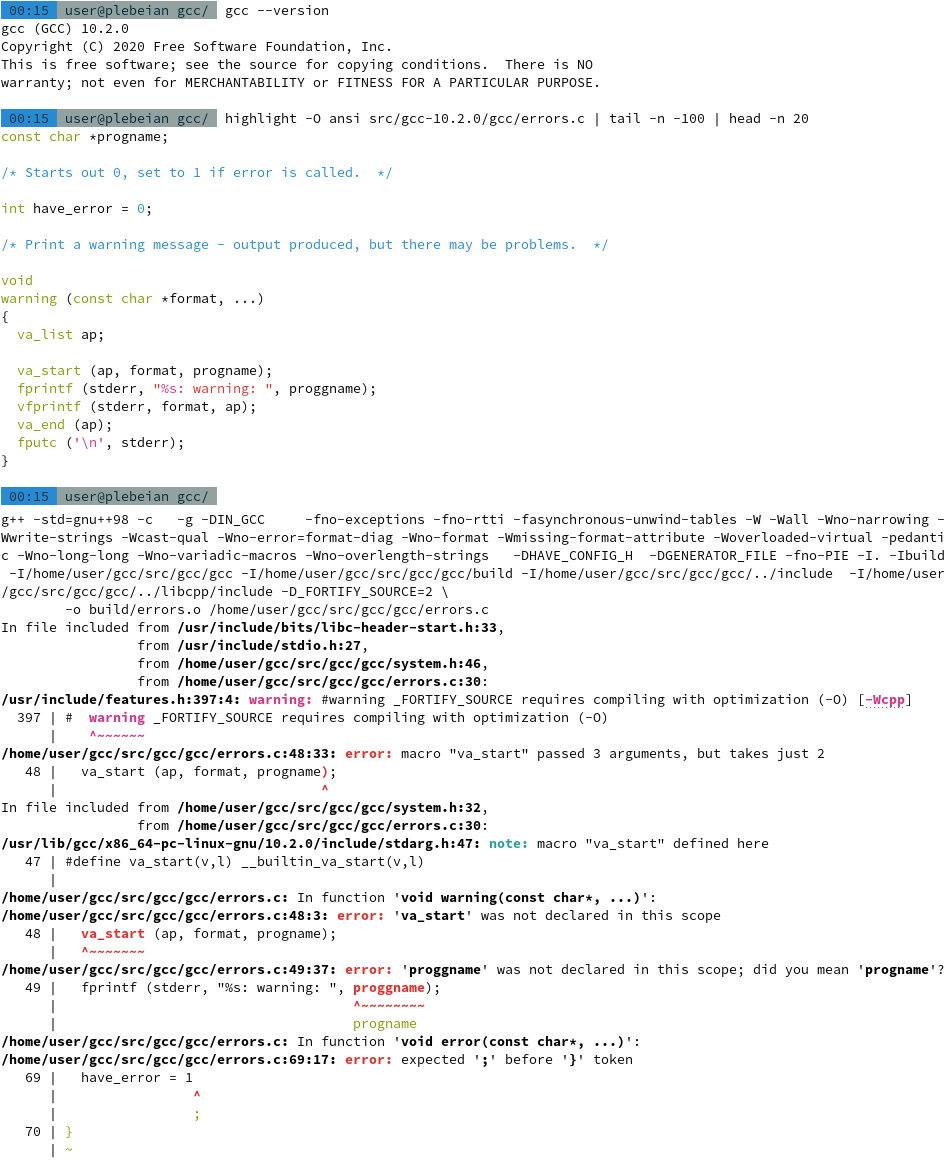
GCC Steering CommitteeはAIによる貢献に関するポリシーを承認し、原則としてLLMの出力を含む、またはその出力から派生した実質的なコードや文章を拒否する。モデルは引き続きデバッグ、分析、レビューに利用でき、メンテナーは生成されたテストを受け入れることもできるが、その出力を通常の貢献に直接含めることはできない。
 代理工具
Change2Taskは、マージ済みPRから開発意図を抽出し、同じリポジトリの現行バージョン上で実行可能なタスクとして再構築する。研究では1,130件の候補変更から900件のタスクセットを生成したが、大半のケースでは再構築に別のコーディングエージェントを必要とした。
 代理工具
MemHarnessは、検索した過去の経験をそのまま再生するのではなく、同じポリシーモデルに現在の状態に照らして批判・再構成させたうえで、行動を決定する。GRPOによるエンドツーエンド学習後、ALFWorldとWebShopでそれぞれ85.2%と75.6%の成功率を達成したが、コードと重みはまだ公開されていない。