 代理工具
StateBridge、閉形式アライメントでエージェント間の隠れ状態を伝送――26組のテスト中22組で単独または同率首位
StateBridgeは直交Procrustes変換を用いて、送信エージェントの最終層の隠れ状態を受信エージェントの入力埋め込み空間へマッピングし、プロジェクターの学習を不要にする。4モデルの平均スコアは最強のベースラインを2.4~2.9ポイント上回ったが、現時点では同一のモデル重みを使用するエージェントのみをサポートする。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
代理工具
StateBridgeは直交Procrustes変換を用いて、送信エージェントの最終層の隠れ状態を受信エージェントの入力埋め込み空間へマッピングし、プロジェクターの学習を不要にする。4モデルの平均スコアは最強のベースラインを2.4~2.9ポイント上回ったが、現時点では同一のモデル重みを使用するエージェントのみをサポートする。
 最新模型
AlayaWorldは、インタラクティブ世界モデルの空間メモリと条件付けパイプラインを刷新し、カメラ制御、過去フレーム、生成コンテンツに整合した因果VAE表現を使用するようにした。新たな報告ではWBenchで一貫性の総合スコア首位を記録したが、新版の重みと推論コードはまだ同時公開されていない。
 推論系統
GCacheは、隣接するデノイズステップ間の局所的な類似度で再計算の要否を決めるのではなく、最終的な画質への影響が最小となるキャッシュ再利用シーケンスを探索する。Wan2.1で2.17倍の高速化を維持しながら偏差を大幅に抑えた一方、方策探索には複数のH100が必要で、実装もまだ公開されていない。
 推論系統
新手法は、数千から1万個の有効な文字列に対してtrieの状態とtoken maskを事前構築し、汎用文法コンパイルにおけるカーディナリティのボトルネックを回避する。著者らの測定では、バッチサイズ256で毎秒219リクエストを処理した。ただし実装はまだ公開されておらず、この数値には既存のguided decoding経路を迂回する統合上の効果も含まれる。
新研究發現,混合線性注意力模型的巨量啟用並非隨機散布,而會在完整注意力層前形成尖峰,並於中間的線性層維持平台。團隊公開分析程式與受控模型,但完整論文圖表所用的逐筆輸入尚未全部釋出。
 代理工具
新たな研究が一般化可能性理論を用いて TheAgentCompany、τ²-bench、AppWorld を分解した結果、エージェントとタスクの交互作用が、エージェント自体の平均的な差を大きく上回ることが分かった。著者らは DDR レポーティング・フレームワークを提案し、選定時にタスク難易度、ホールドアウト検証、コスト、必要サンプル数を併せて報告するよう求めている。
 代理工具
LLNLのチームは、エージェントにFlux、Slurm、Kubernetesなどのリソースを探索させ、高レベルの意図を検証可能なジョブ仕様へ変換した。6つのクラウドクラスターでの実験から、アーキテクチャ、ネットワーク、メモリのmetadataは、実行不能なマシンの除外には主に役立つものの、安定した性能オプティマイザーではないことが示された。
 代理工具
Graph-Structured Rubricsは、評価対象の回答を見る前に、自然言語のrubricを型付きの判定、変換、集約、ゲートノードへコンパイルする。GPT‑OSS‑120Bを用いた実験では、フラットなPrometheus方式の採点を上回ったが、現時点で実装コードは公開されておらず、改善幅もデータセットに大きく依存する。
 最新模型
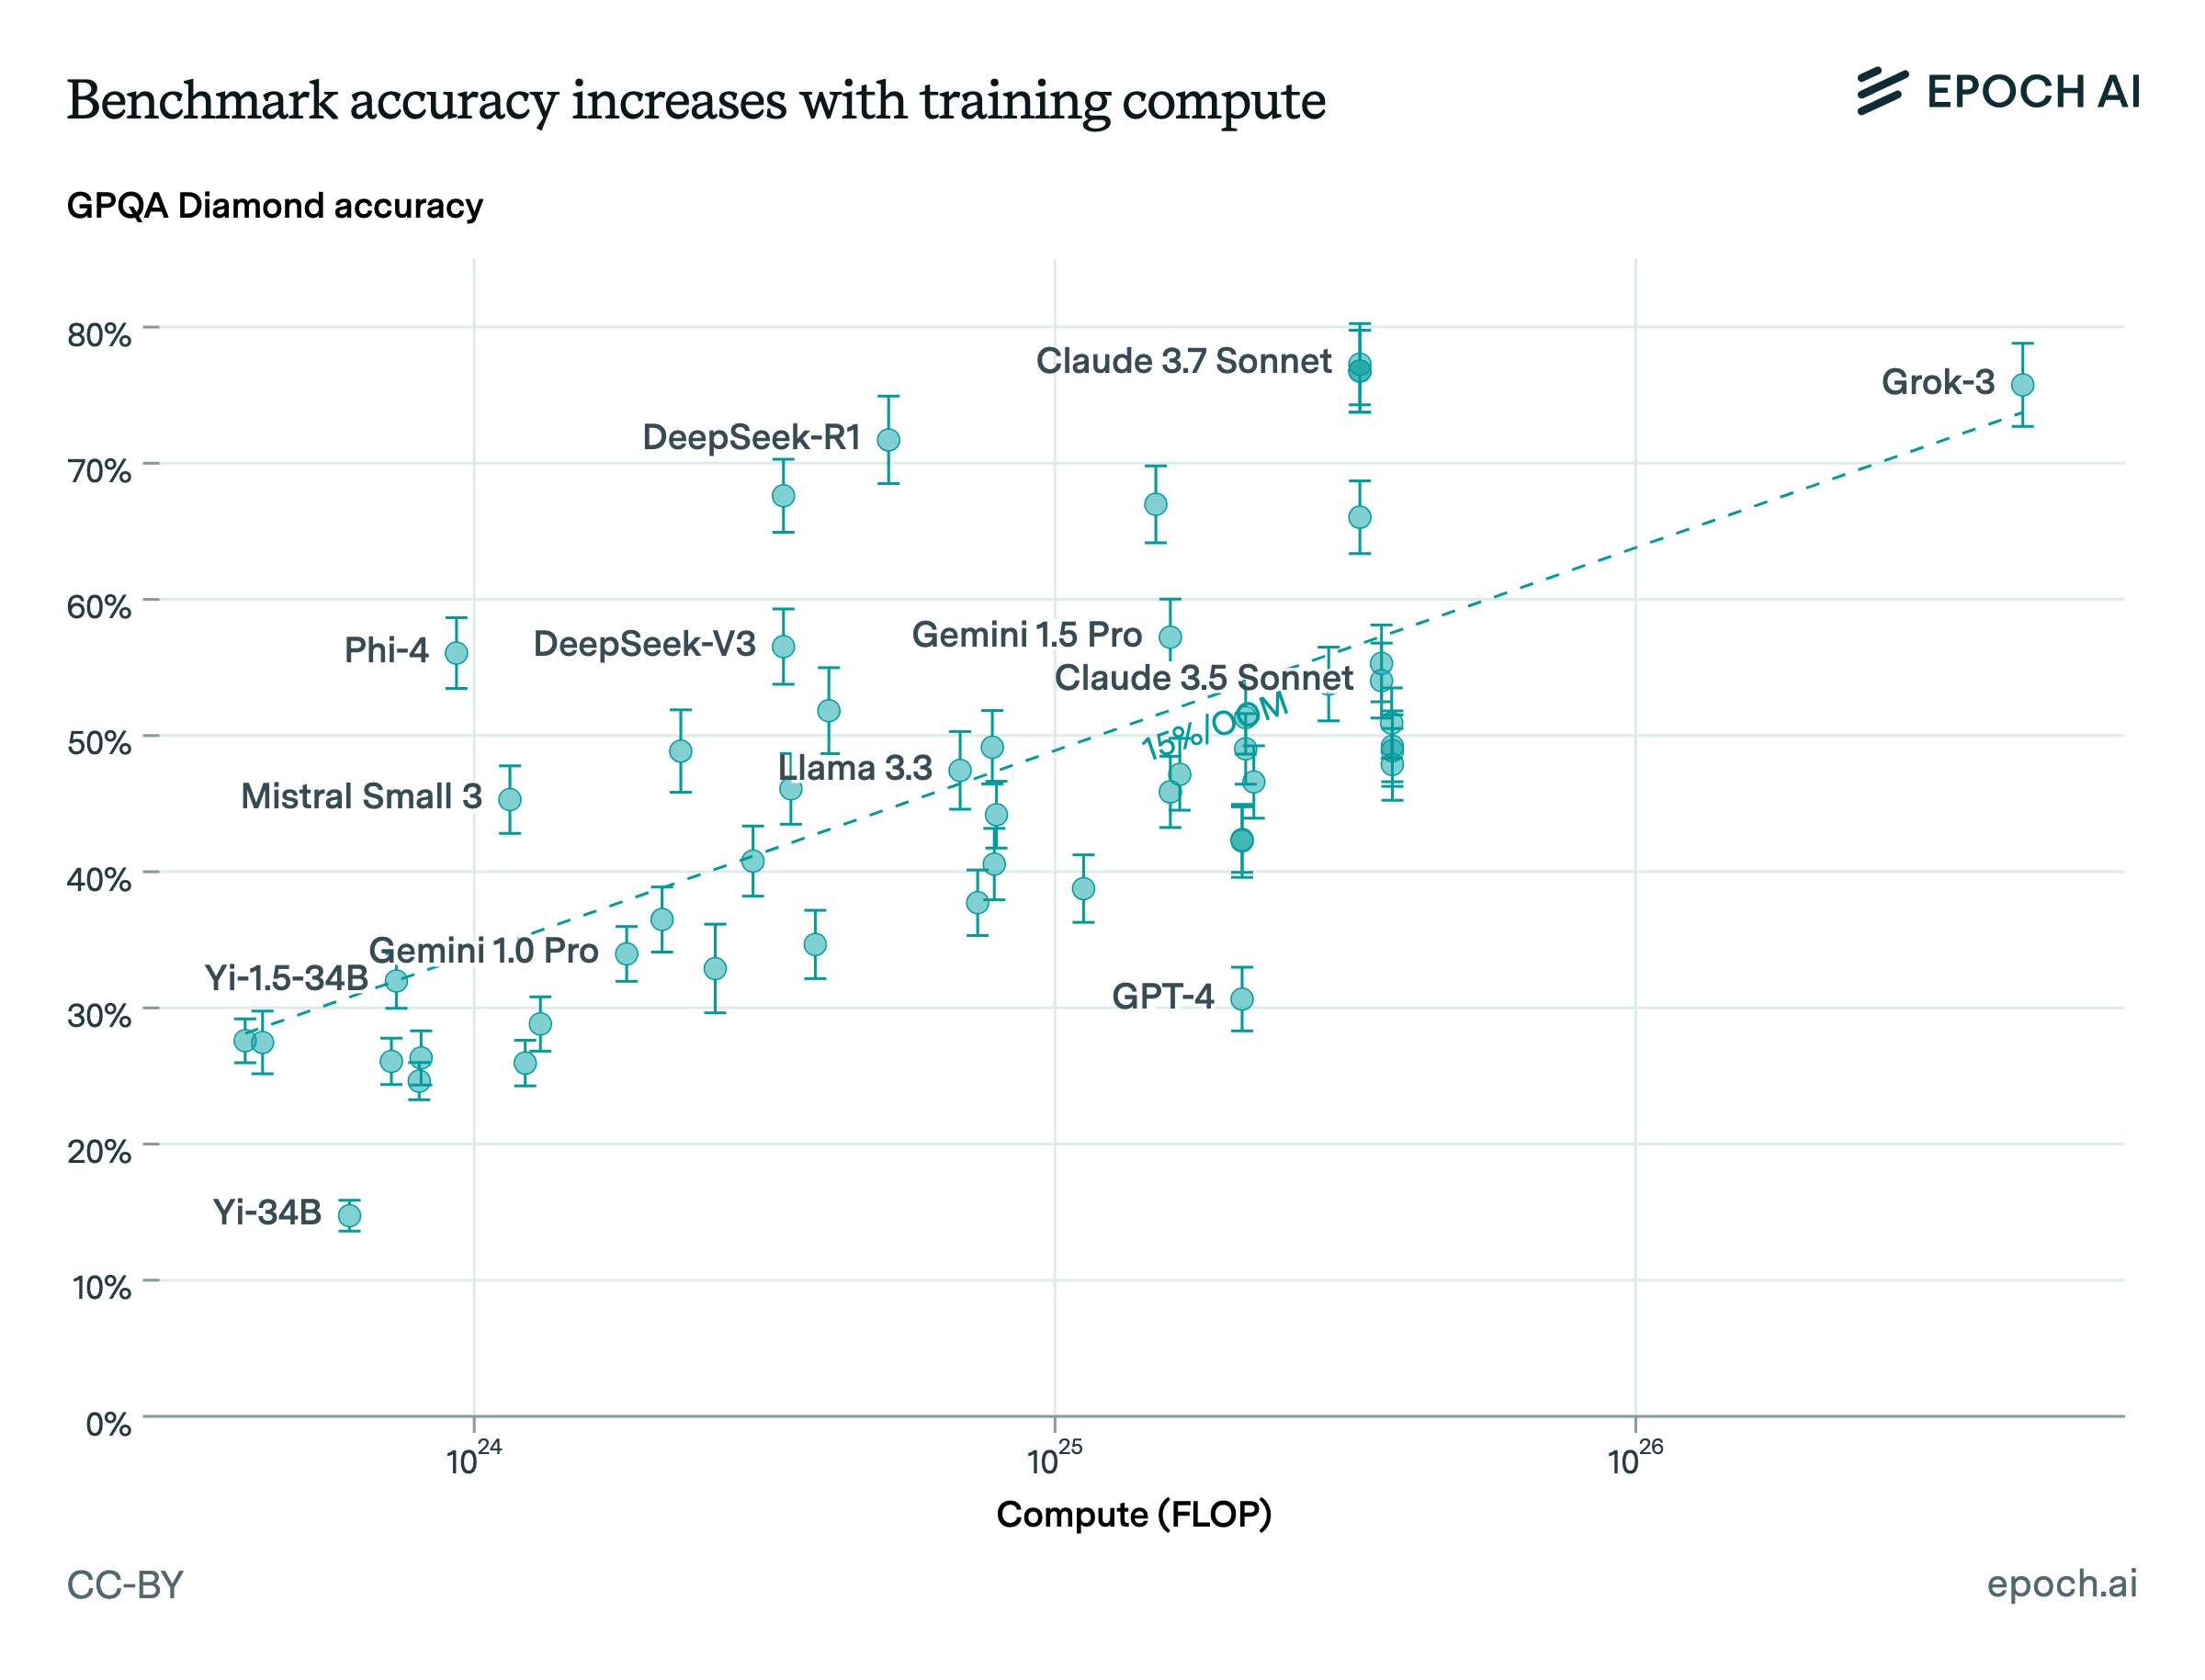
事前登録研究により、Qwen2.5-7BとLlama-3-8Bは、GPQA Diamondの問題の大半で投票数を増やすほど誤答に収束しやすくなることが分かった。全体の平均スコアはなおわずかに上昇しており、集約指標が問題ごとの性能低下を覆い隠すことを示している。
 代理工具
Harness‑IFは、ルールをシステムプロンプト、プロジェクトファイル、ユーザー指示、ツール記述、スキル記述に分散させ、実際の実行証拠に基づいて一つずつ評価する。12種類の最先端モデルはいずれも、自身のデフォルト傾向に反するルールに直面すると正確率が低下した。
 AI 安全
VICBenchは、人手とエージェントによる二重追跡を通じて、Python、Java、C++プロジェクトにおける100件のCVEのvulnerability-inducing commitをアノテーションした。ファイルをまたぐコード移動やリファクタリングにより、V-SZZとLLM4SZZでは多数の誤判定が生じ、影響を受けるバージョンに関するデータの信頼性にも問題があることが明らかになった。
 最新模型
AlibabaのQwenがQwen3.8‑2.4T‑A95Bを公開した。512のエキスパートと、線形Attentionおよび標準Attentionのハイブリッド構成により、最長約101万tokenに対応する。推論深度は調整できるものの、入力はテキストのみで、思考モードを無効化できない。実際のデプロイ要件は、一般的なオープンウェイトモデルをはるかに上回る。