 代理工具
Quipu、エージェントによる知識グラフへの書き込みを「検証後にコミット」へ転換、拒否記録もバージョンをまたいでリプレイ可能に
Quipuは、データ、信頼ラベル、ルール、裁定をまとめて二重時間軸の対象とし、エージェントの書き込みをコミットする前に候補状態を検査する。作者による欠陥注入テストでは、ゲートなしの場合に6件すべてが残存したのに対し、残存数はゼロになった。ただし、証拠は依然として主にシステム作者が設計した単発の決定論的評価に基づく。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
代理工具
Quipuは、データ、信頼ラベル、ルール、裁定をまとめて二重時間軸の対象とし、エージェントの書き込みをコミットする前に候補状態を検査する。作者による欠陥注入テストでは、ゲートなしの場合に6件すべてが残存したのに対し、残存数はゼロになった。ただし、証拠は依然として主にシステム作者が設計した単発の決定論的評価に基づく。
 AI 安全
CompoSkillは、スキルの安全性を単一パッケージの判定ではなく、スキルをまたぐデータフローと副作用の経路問題として捉え直した。1,140件のテストでは、ホワイトボックス攻撃とブラックボックス攻撃によるリスクチェーン形成率がそれぞれ最大83.3%と80.6%に達したが、これは実環境での侵入成功率を意味するものではない。
 代理工具
ClawGym II はエージェントフレームワークの内部を変更せず、モデルサービス境界で呼び出しをインターセプトし、prefix tree を用いて複数ターンの軌跡を復元する。訓練後の Qwen3-30A3B は、OpenClaw と Claude Code で ClawGym-Bench を実行した際の Pass@1 が、それぞれ9.98ポイント、14.81ポイント向上した。
 AI 安全
新たな研究により、複数のguard modelとactivation probeは、ルールを削除、シャッフル、置換しても判定精度がほとんど変わらないことが分かった。テキスト上のショートカットを排除するために設計された交差テストでは、高速な検出器の成績はランダムに近く、ルールと文脈を組み合わせる能力が明確に回復したのは、段階的推論モデルだけだった。
 代理工具
Stanfordの研究チームが1万件を超える言語モデル・エージェント社会をシミュレーションし、複数ラウンドのコミュニケーションによって弱い意見が徐々にコンセンサスまたは分極化へ向かうことを明らかにした。研究では拡張Isingモデルを用い、未観測の通信グラフにおける個々の軌跡を予測したが、政治的設問では右寄りへのシフトも生じ、協調が必ずしもモデルのバイアスを解消しないことが示された。
 AI 安全
JailbreakSkillは、プロンプトの書き換え、失敗分析、スキル進化を統一インターフェースでカプセル化し、レッドチーム・エージェントが未成功の攻撃軌跡から新たな手順を生成できるようにする。第2段階により、AdvBenchとHarmBenchにおけるモデル横断の平均攻撃成功率は、それぞれさらに17.5ポイントと13.4ポイント上昇したが、評価はGPT-4oによる判定に依存している。
 推論系統
ParaTempoは各推論パスの暫定回答分布を定期的にプローブし、その結果に基づいて刈り込み、早期終了、分岐を個別に実行する。Qwen3.5-35B-A3Bでは、4つのベンチマークにおける平均精度が固定16パスのself-consistencyを1.1ポイント下回った一方、レイテンシと生成token数をそれぞれ21.8%と30.3%削減した。
 代理工具
PACE-Benchは、144件の実行可能な物理環境を用い、摩擦や材料の制約が変わったことで動作しなくなった、過去には成功していたプログラム設計をエージェントが修正できるかを検証する。実験では、未検証の自己修正よりReflexionが優れる一方、長期記憶はむしろ高性能なモデルを初期案に縛り付けることが示された。
CForce 沿用擴散語言模型自己的生成軌跡,把後期較完整的預測蒸餾回早期遮罩狀態。LLaDA2.1-mini 在提高平行解碼量的同時維持準確度,但證據目前集中於同一模型家族與作者控制的評測。
 最新模型
sMuonは、完全な重み行列に対する直交化方向を、LoRA因子で表現可能な低ランク空間へ射影したうえで、純粋な行列乗算によって更新を計算する。ReLoRA実験ではRiemannionと同じ最低検証損失を達成した一方、複数モデルのファインチューニング結果は、基盤モデルの事前学習に用いられたオプティマイザに大きく依存した。
 代理工具
ScienceFlowは会話の要約を保存するだけでなく、コード、検証エビデンス、リソース記録、ワークスペースのスナップショットを、復元可能なStageとしてパッケージ化する。公式報告では、MLE-bench全75問でAny-Medal率70.22%を達成したが、システム間の比較は依然としてモデル、ハードウェア、時間予算の違いに左右される。
 最新模型
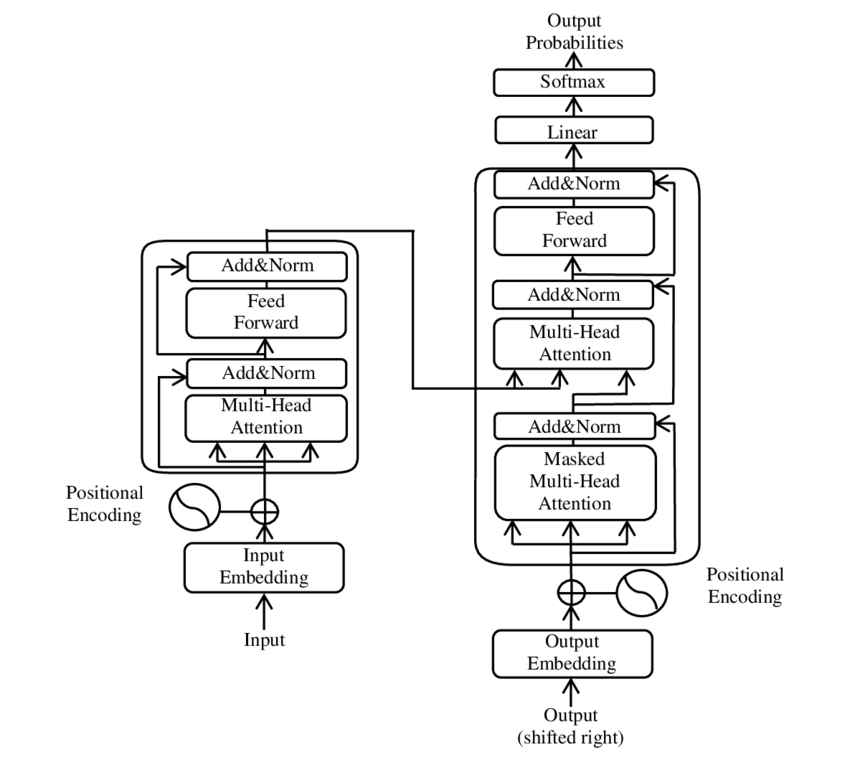
Intern-S2-Mobiusは、従来のTransformerで各層に結び付いていた知識ストレージと注意機構による推論を分離し、複数のReasonerが同一のグローバルMemoryを繰り返し参照できるようにする。オープンウェイトはLMDeploy、vLLM、Transformersで読み込めるが、約4倍という高速化は、あくまで公式の特定ベンチマークにおける結果だ。