 生成式視覺與 4D 重建
4DAnyoneがモデルと推論コードを公開、単眼人物動画を最大48の再構成視点へ拡張
固定長の参照コンテキストと、拡散プロセス中の視点再編成により、多視点動画を分割生成する際の構造的ドリフトを抑える。重みと推論パイプラインは公開されたが、4D Gaussian Splattingによる再構成の完全なオープンソース化と低メモリモードはまだ実現していない。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
生成式視覺與 4D 重建
固定長の参照コンテキストと、拡散プロセス中の視点再編成により、多視点動画を分割生成する際の構造的ドリフトを抑える。重みと推論パイプラインは公開されたが、4D Gaussian Splattingによる再構成の完全なオープンソース化と低メモリモードはまだ実現していない。
 代理工具
MCPメンテナンスチームは、次段階の仕様策定を、サーバー主導イベント、エージェントアイデンティティ、段階的なツール探索など5つの領域に集約した。これらはまだロードマップ上の項目であり、既存SDKによるTasksと拡張通知のサポートにも不足がある。
 最新模型
DeepSeekはV4-Flashに画像理解機能を追加し、互換性のある3種類のインターフェースを通じてテキストと画像を処理できるようにした。料金体系は従来のFlashモデルと同じだが、公式発表のエージェント評価スコアは独立した再現検証がなく、モデルウェイトやビジョンアーキテクチャも公開されていない。
 代理工具
新バージョンでは、エージェントのSkillsを一元的に保存、検索、キャッシュする仕組みをVikingBotに統合したほか、ユーザー単位のメモリ取得ポリシーと永続化可能なバックグラウンドインポートを追加した。同時に、実験的なRelations APIとCLIコマンドが削除されたため、既存の統合環境ではアップグレード前の移行が必要となる。
 代理工具
Hume AIとHugging Faceは、音声が公開テストセットの正解と矛盾する場合でも、一部の高スコア音声モデルが参照トランスクリプトの内容を出力することを発見した。Open ASR Leaderboardには「Benchmark Fitting」タブが追加されたが、こうした挙動は、モデルがテストデータを直接見たことの証明にはならない。
 AI 安全
Semantica 0.6.6は、ナレッジグラフのインポート、バックアップ、エクスポート、外部リクエストに関する複数種類の脆弱性を集中的に修正した。メンテナーは、すべてのデプロイ環境にアップグレードを推奨している。新バージョンでは、出典記録を保持できる事実の撤回機構とCrewAI統合も追加された。
 推論系統
YutoriのNavigatorは、ブラウザタスクごとに視覚言語モデルを数十回連続で呼び出し、履歴コンテキストは最大約100K tokenまで増加する。Together AIはvLLMのプレフィックスキャッシュとレイテンシ目標別のルーティングでこの負荷を処理するが、2倍の速度と4~5分の1の低コストという数値は、依然としてベンダーが公表した比較結果である。
 代理工具
Nous Researchは、APIキー不要のウェブ検索、スケジュールタスクのメモリ、実行停止への保護機能をHermes Agent 0.20.5に導入した。パッチ版と位置付けられているものの、約323件のPRがマージされており、完全な移行ガイドは0.21.0を待つ必要がある。
 代理工具
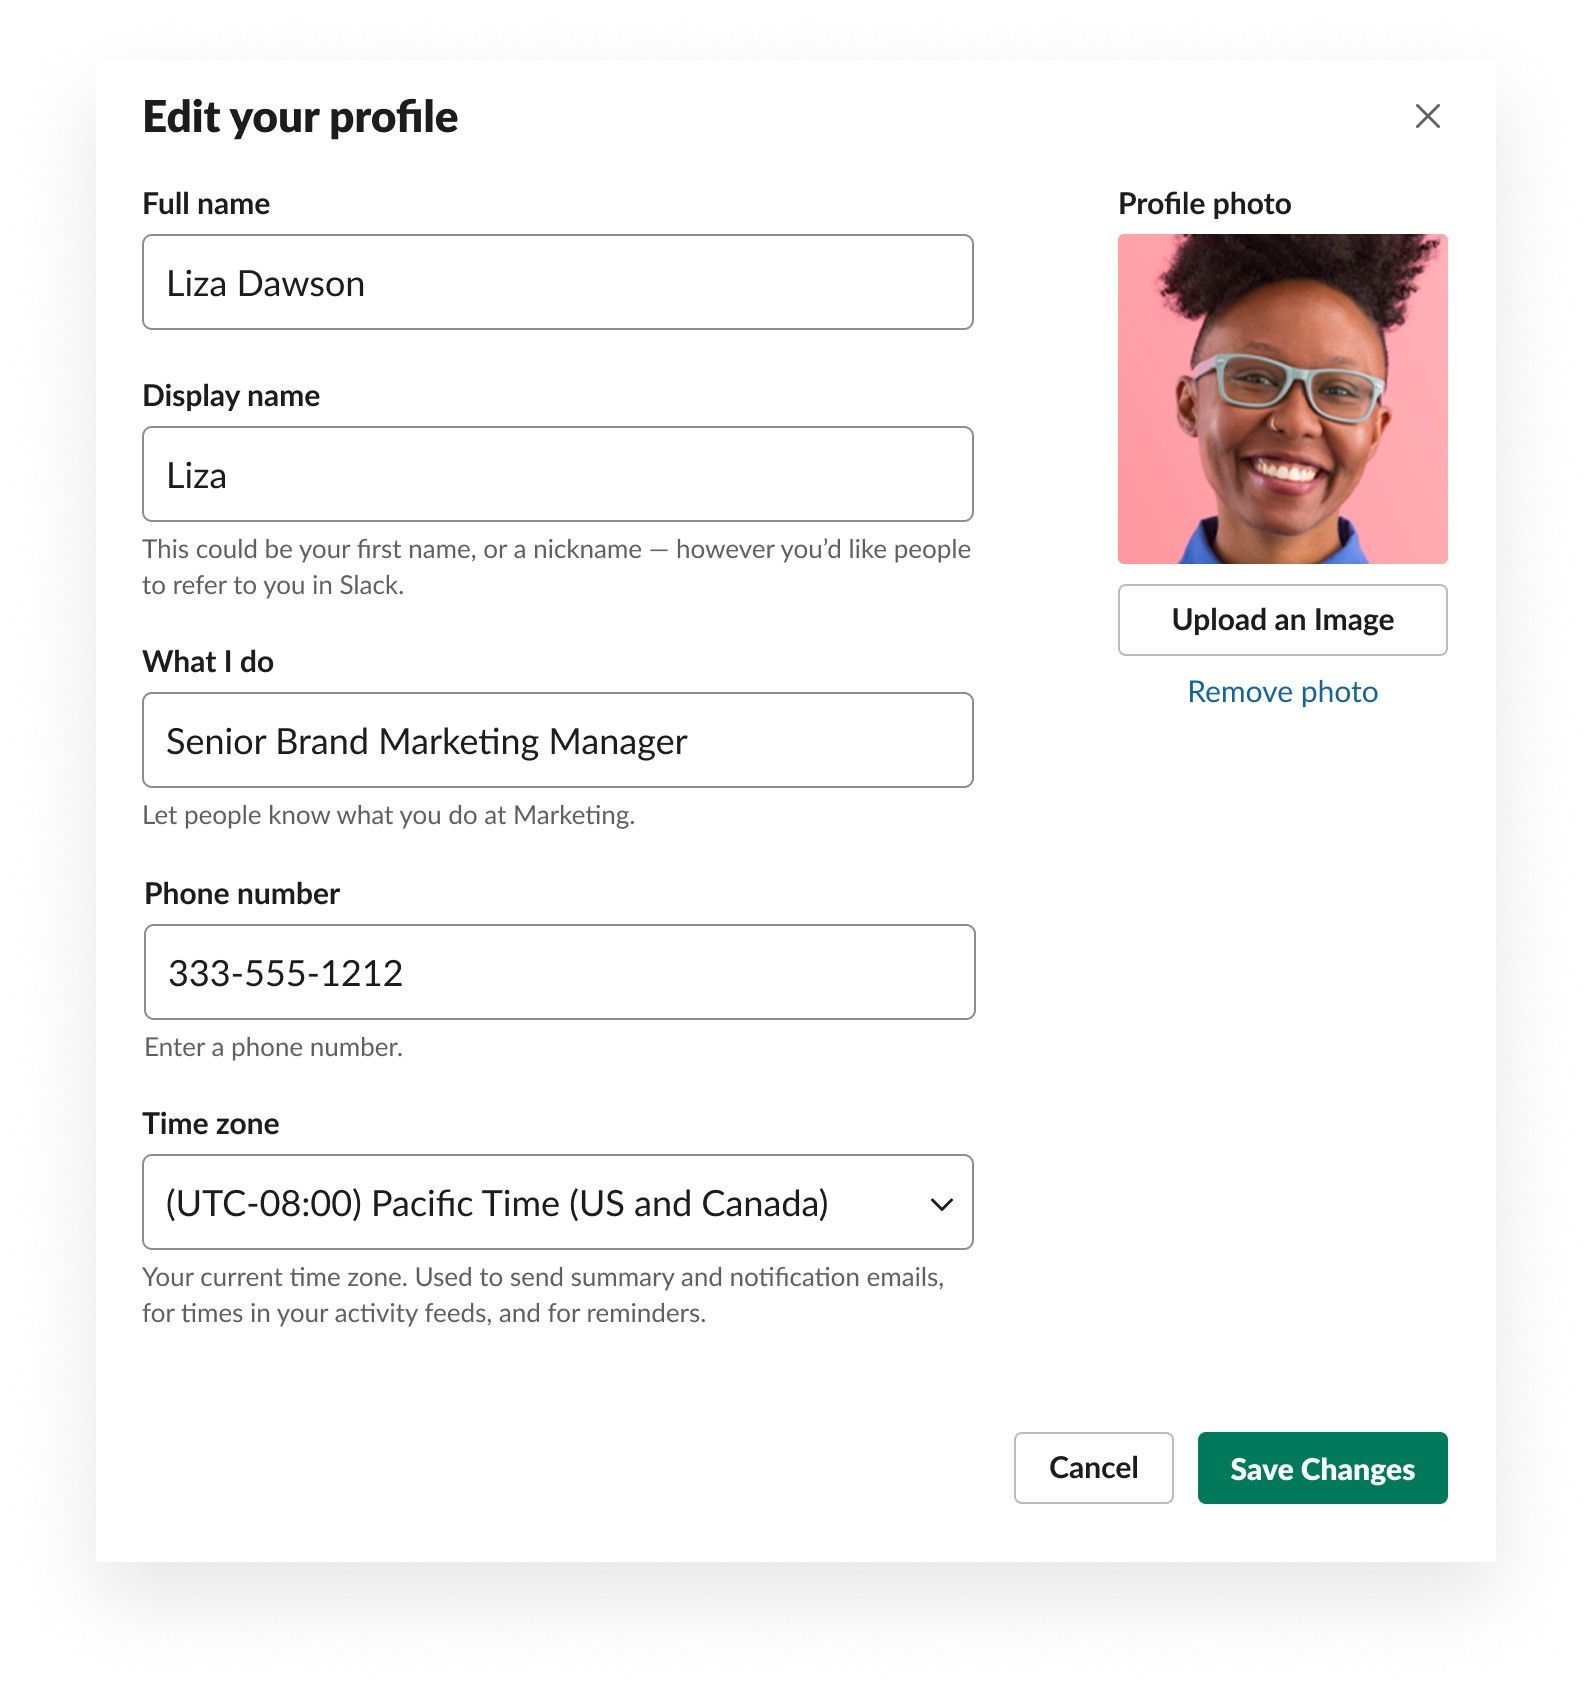
Slack Codeでは、Claude、Devin、Copilot、ChatGPT、Vercelのエージェントが、プロジェクト専用チャンネル内で計画、コード差分、リアルタイムプレビューを提示できる。複数人でエージェントを監督するためのインターフェースは改善されるが、実行サンドボックス、認証情報、リポジトリ権限は引き続き各エージェントプロバイダーが管理する。
 推論系統
Liquid AIは、3種類のLFM2.5モデル向けに約3億パラメータのDSparkドラフトチェックポイントを公開し、llama.cppとSGLangに統合した。公式テストでは、モデル、データ分布、ハードウェアによって高速化の度合いが大きく変動しており、ピーク値をすべてのワークロードで得られる効果とみなすことはできない。
 最新模型
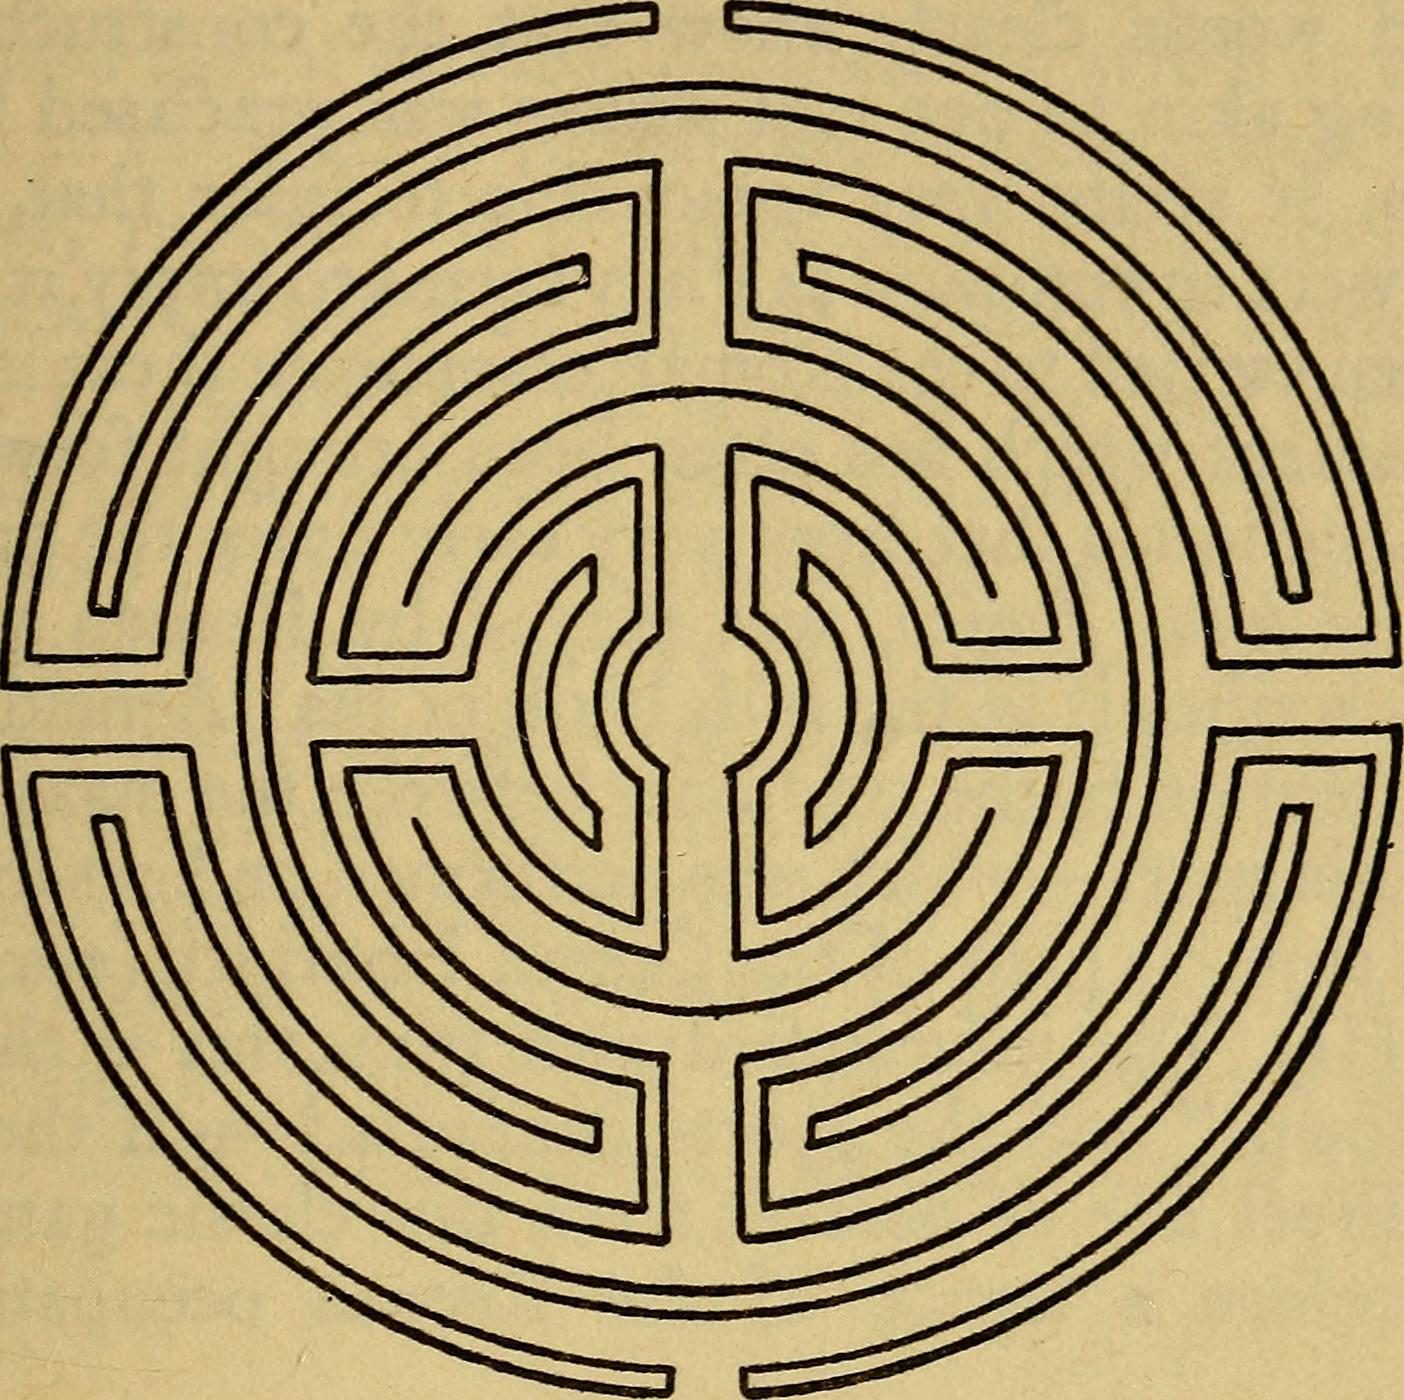
RuleMazeは、実行可能な検証器を用いて、マルチモーダルモデルが迷路を理解し、自然言語のルールを守りながら経路計画を完遂できるかを評価する。DMPは知覚、移動、ルール検証を分離することで通常のファインチューニングを大幅に上回ったが、テストは依然として合成グリッドに限定され、検証器にも人手による修正が加えられている。
 代理工具
Task Model Inductionは、画面と入力のログ全体を単一のワークフローに圧縮するのではなく、まず非連続のタスクを分離し、その後に目標階層とループ制御フローを再構築する。生成されたエージェントスキルのホールドアウト問題における精度は、最良ベースラインの14.29%から18.57%に向上した。一方、パイプライン全体がフロンティアモデルに依存し、生の操作トレースには重大なプライバシーリスクが伴う。