 代理工具
Googleがautofinetuneを公開:エージェントがTPU上でSFTとGRPOの学習設定を自動探索
autofinetuneでは、エージェントがMarkdown仕様に基づいてTunixの学習プログラムを変更し、評価を実行したうえで、指標が改善したGit commitだけを保持する。初期実験ではFunctionGemmaのSFTとGemma 3 1BのGRPOを扱っているが、現時点では小規模かつ単一指標による探索的なプロセスにとどまる。
Archive
Agent、MCP、coding agent、工作流自動化與評測。
代理工具
autofinetuneでは、エージェントがMarkdown仕様に基づいてTunixの学習プログラムを変更し、評価を実行したうえで、指標が改善したGit commitだけを保持する。初期実験ではFunctionGemmaのSFTとGemma 3 1BのGRPOを扱っているが、現時点では小規模かつ単一指標による探索的なプロセスにとどまる。
 AI 安全
Gemini CLI 0.61.0の9月12日版nightlyは、外部コンテンツから派生したコマンド引数を追跡し、ビルド設定が変更された後にユーザーの承認を再度求める。別の一連の修正では、ホームディレクトリ、認証情報、`.env`がサンドボックスにマウントされるのを防ぐが、安定版はまだリリースされていない。
 最新模型
SenseNova-U1.5は、独立した視覚エンコーダーやVAEに依存しないMoTアーキテクチャを採用し、単一モデルで理解、推論、生成、編集を処理する。9月11日に追加された技術レポートでは学習手法と評価結果が開示された。既存の重みと推論コードは利用できる一方、SFT、RL、multi-expert distillationのコードはまだ完全には公開されていない。
 代理工具
Context7のDocs7では、対応ブラウザ上のエージェントが`search_docs`を直接呼び出せるようになり、管理者はエージェントの送信元、クエリ内容、人気ページも確認できる。これにより、ドキュメントチームはエージェントがどのように情報を探しているかを初めて観察できるようになった。ただし、関連指標は引用や回答の正確性を証明するものではなく、WebMCP自体も依然としてコミュニティ草案にすぎない。
 代理工具
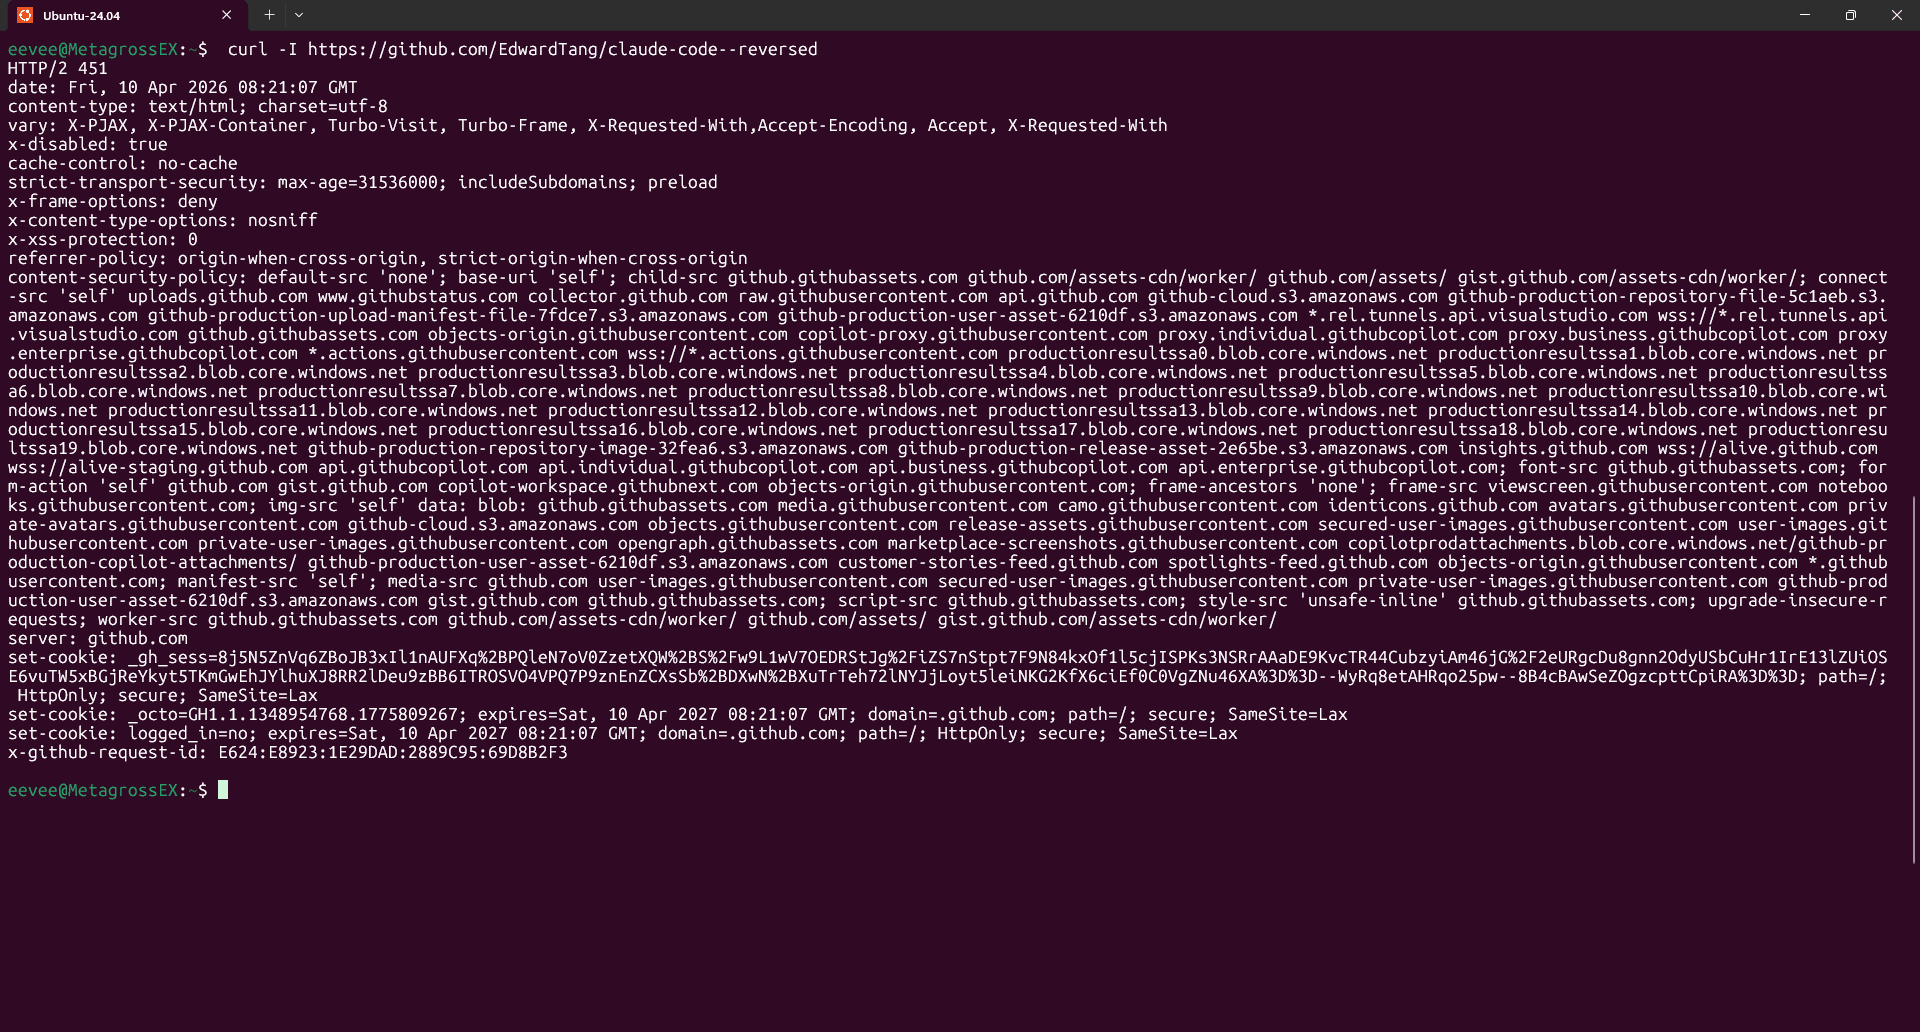
新コマンド `claude plugin eval` により、プラグインの有効時と無効時のパフォーマンスを比較し、JSONおよびHTML形式の評価レポートを出力できる。初期検証では、自動生成されたルールは指示への準拠を検証しやすい一方、プラグインがタスクの品質を実際に改善したことを必ずしも証明できないと示された。
 代理工具
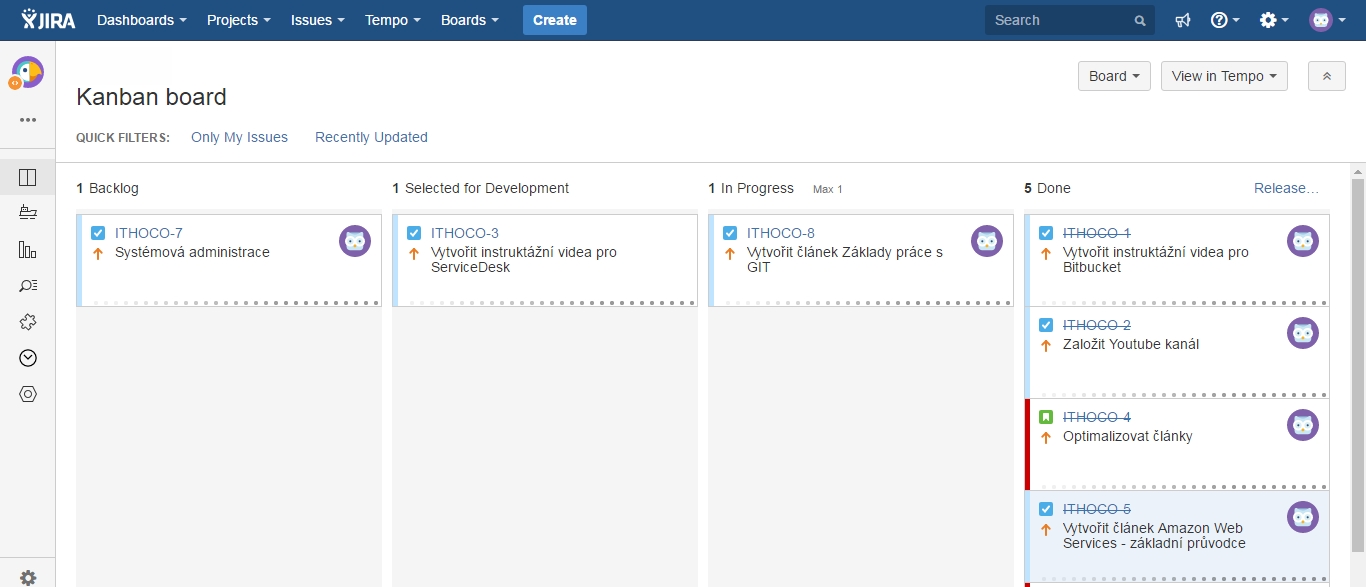
AtlassianはJiraを、エージェントの起動ポイントから、バックログの継続的なスキャン、実装の割り当て、PR作成を担うコントロールプレーンへと拡張する。さらにTeamwork Graphを通じ、複数リポジトリを扱うエージェントに組織のコンテキストを提供する。中核機能の多くは依然としてオープンベータまたはプライベートプレビュー段階にあり、現時点では全面展開可能な成熟したパイプラインというより、評価可能なアーキテクチャの方向性と見るべきだ。
 最新模型
TinyDiTは、1基のRTX PRO 6000を用い、400,000ステップ、3.5日間で210MパラメータのDiTをゼロから学習し、コード、重み、段階別の計測結果を公開した。その結果、flow-matching lossは画像生成の進捗をほとんど反映しない一方、register、timestep shift、コンパイル済み学習は、より実用的なシグナルをもたらすことが示された。
 代理工具
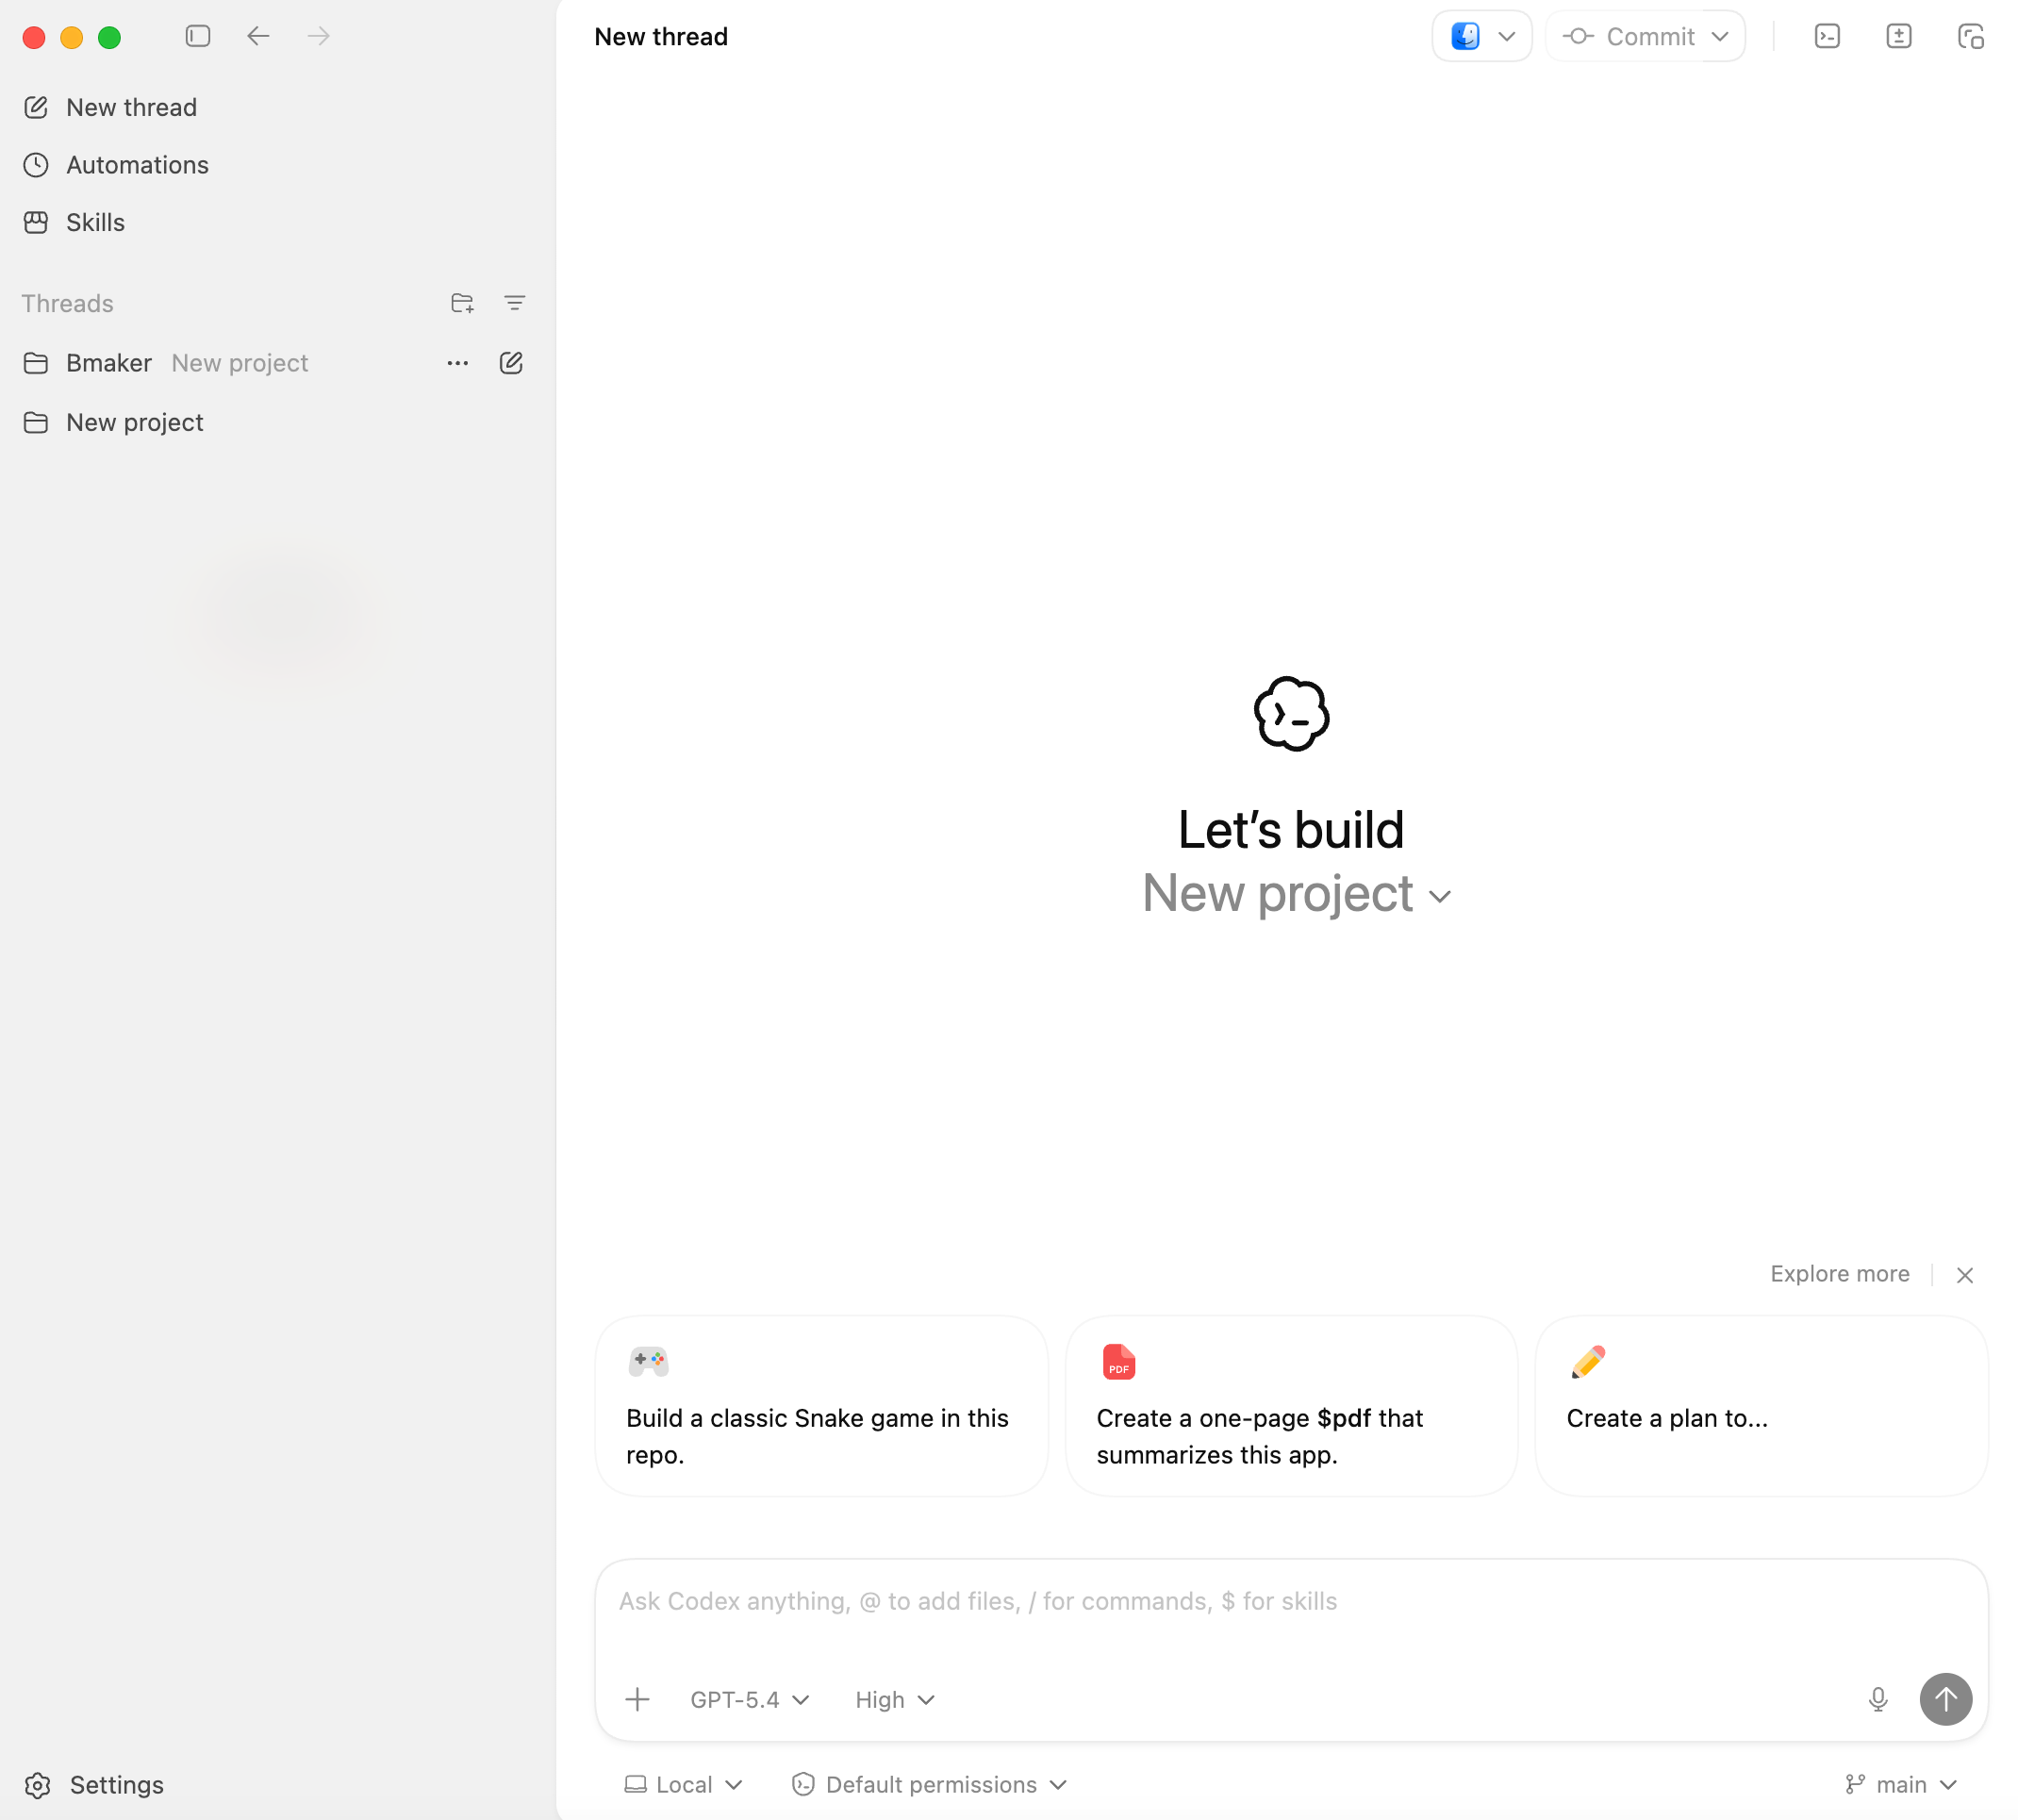
新しい `ExternalMessage` により、ツール、他のエージェント、アプリケーションのイベントを実行中の Codex ターンへ送信できる。同時に、その authority はユーザーや開発者の指示より低い tool-level として扱われる。履歴の読み込みやターン単位のサービスティア制御も追加されたが、アップグレードにはイベントストリーミングと hook 構造に関する互換性変更への対応が必要だ。
 最新模型
T1は各tokenでMoEのエキスパート選択を記録・再生し、数値差によってrollout側と訓練側が異なるサブネットワークを通る問題を回避する。公開weightsはセルフホストできるものの、ベンチマークおよび競合モデルとの比較は依然として主にチーム自身の評価に基づく。
 AI 安全
GitHubは、最も低コストなLite reviewをマルチエージェント・アンサンブル方式に変更した。公式実験では、高重大度の指摘の採用数が47%増加した。レビューエージェントはshellツールも実行できるようになったため、runnerの分離、プロンプトインジェクション、自動解決の監査記録が一段と重要になる。
 最新模型
小鵬汽車(XPeng)は、行動プローブ、クロススケール蒸留、LoRAを用いて、Qwen3-ASR-0.6Bの音声エンコーダーを18層から14層へ縮小した。重みと推論コードは公開済みだが、完全な蒸留プロセスと28万時間超の学習データはまだ公開されていない。
 AI 開發平台
公開ベータ版では、マネージドセッション、コンテキスト圧縮、ツールのオーケストレーション、サブエージェントへのタスク分担を提供し、開発者がエージェントループを自ら保守する必要をなくす。実行環境にはOpenAIのサンドボックス、自社インフラ、提携プロバイダーを選択できるが、バージョン、権限、利用コストは引き続き個別に管理する必要がある。