推論系統
NVIDIA 公布 B200 機密推論測試,特定負載保留逾 96% 吞吐量
八張 B200 執行 DeepSeek-R1 的測試顯示,機密運算下平均每 token 延遲增幅低於 5%。結果依賴記憶體搬移、核心計時與多卡通訊調整,仍須按實際服務負載重驗。
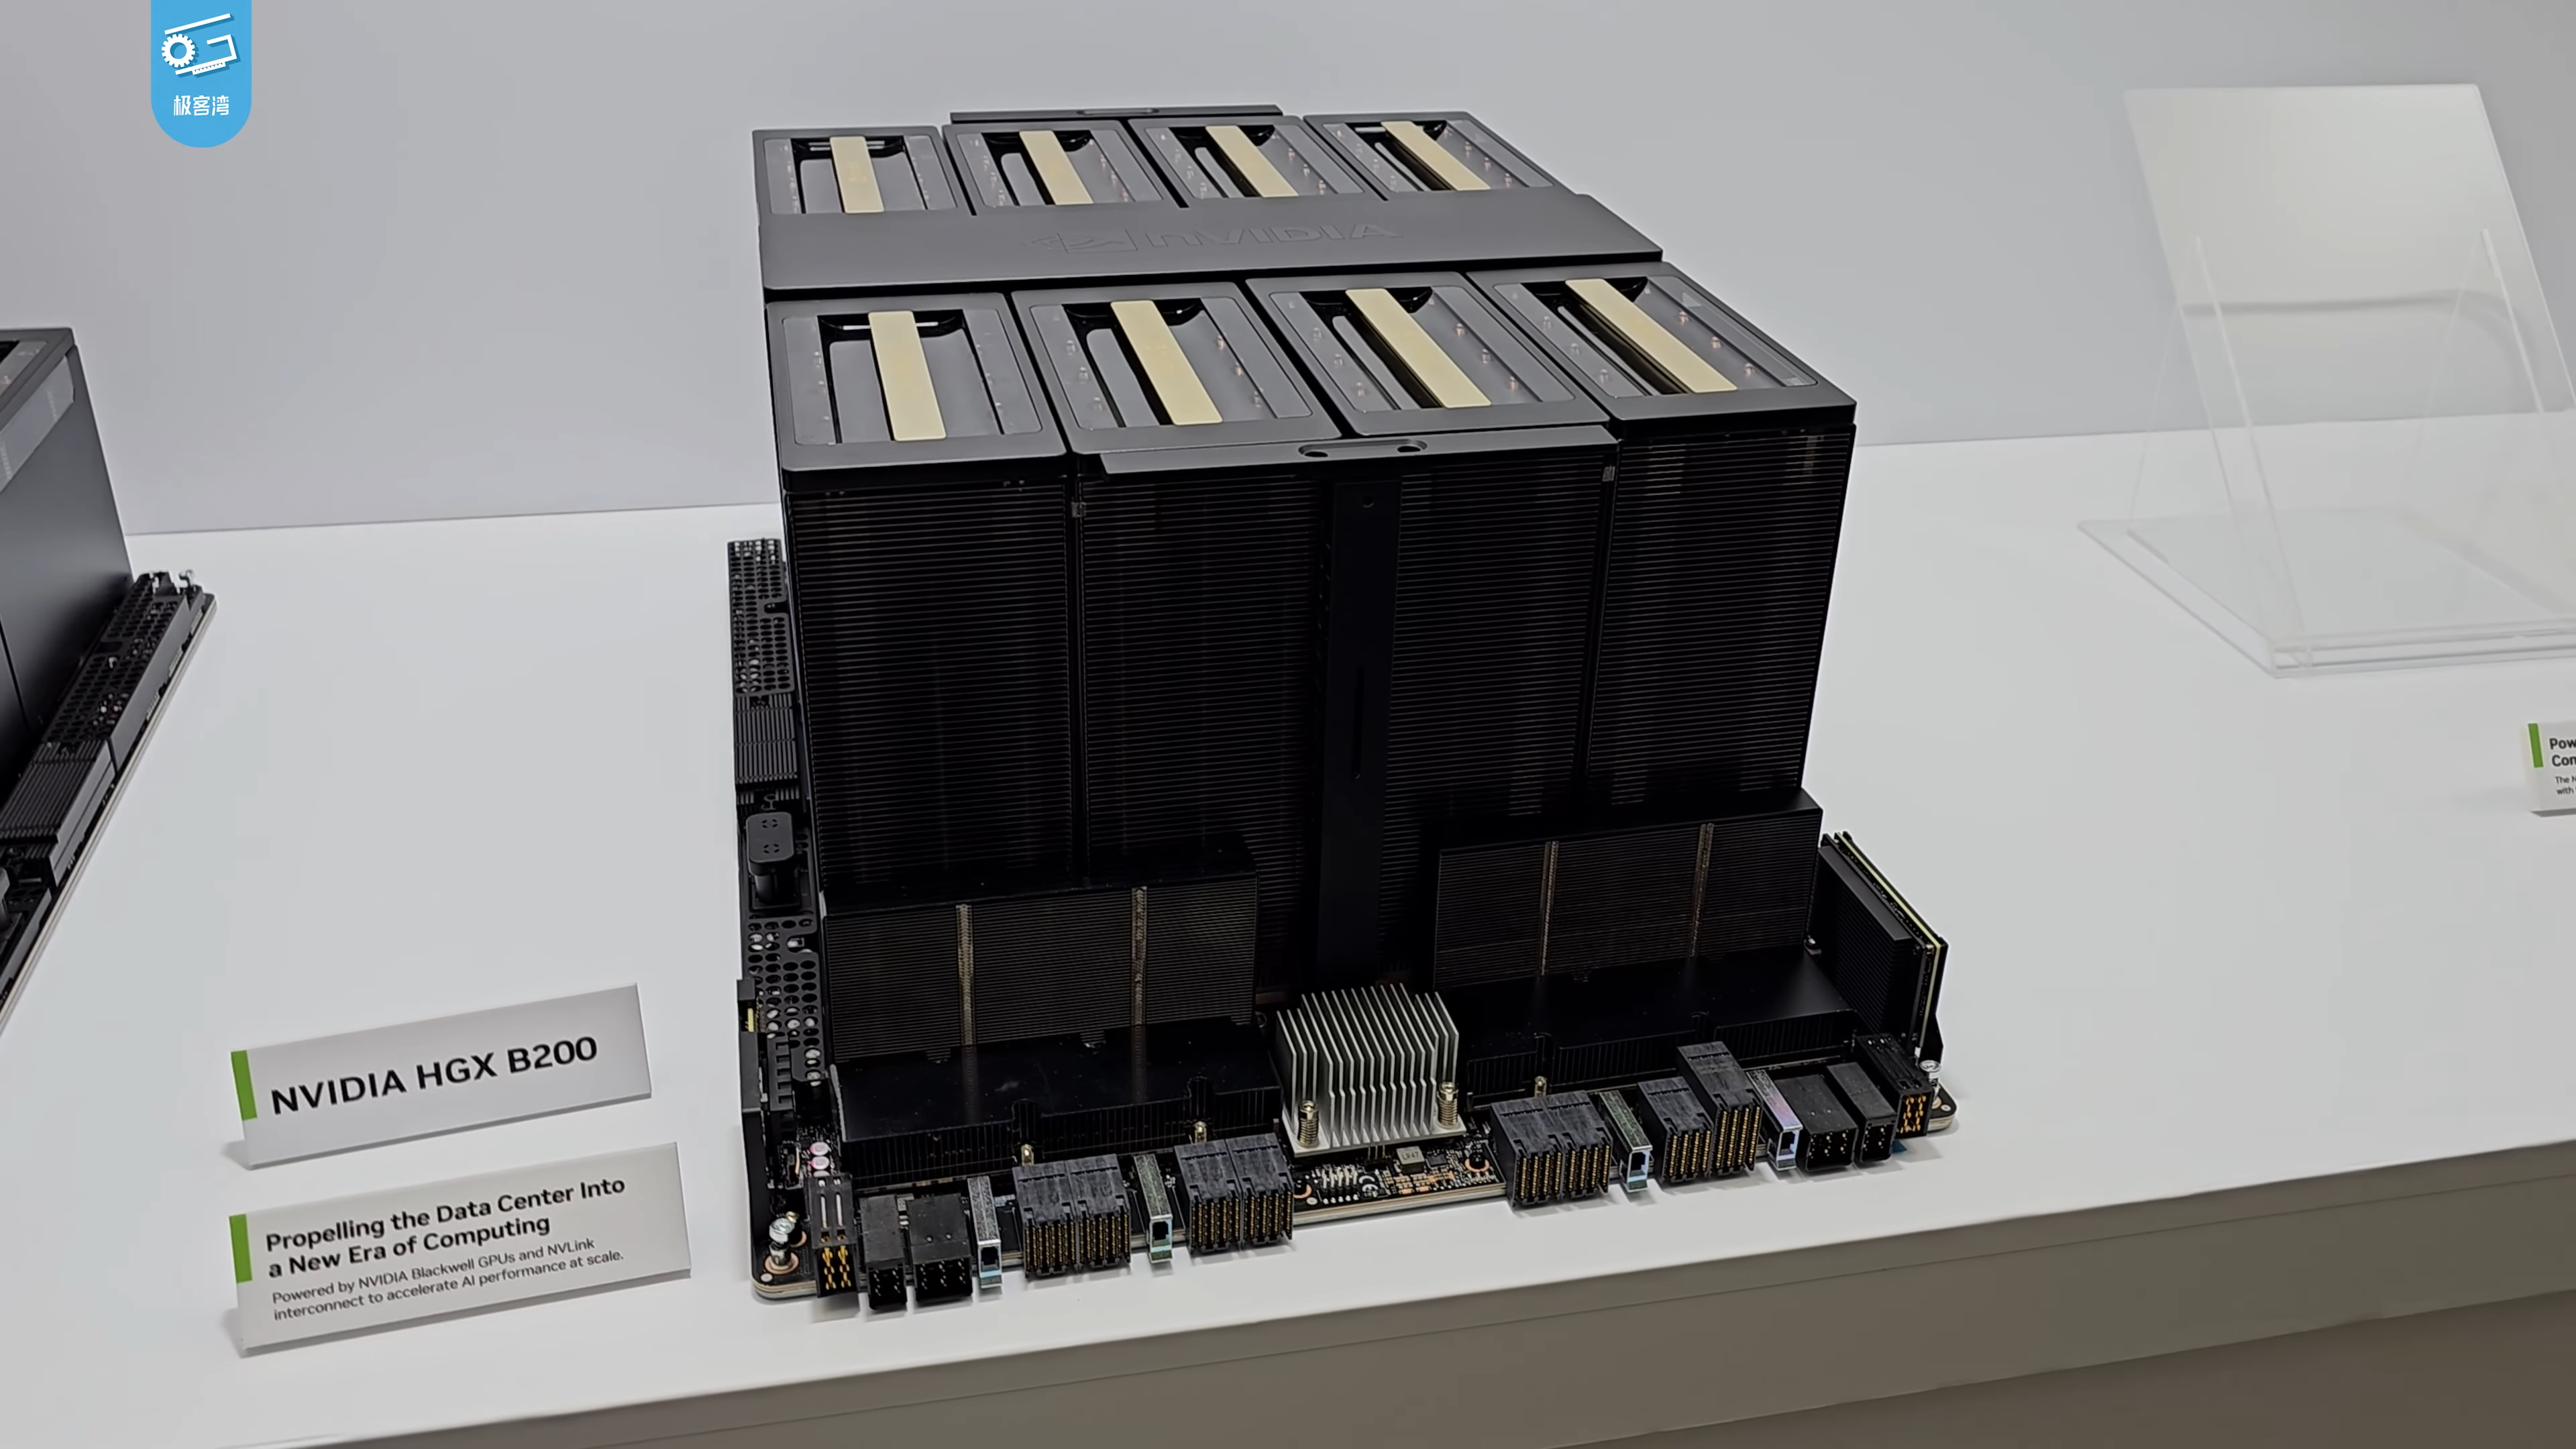
NVIDIA 於 9 月 22 日公布 B200 機密運算推論測試:在八張 GPU 上執行 DeepSeek-R1,啟用保護後仍保留未啟用時吞吐量的 96.1% 至 98.2%,平均每個輸出 token 的延遲增加 1.2% 至 4.3%。這次新增的是測試結果與部署分析,文中引用的兩項 TensorRT LLM 修補早在二月已合併。[官方測試](https://developer.nvidia.com/blog/enabling-private-high-performance-production-ai-inference-with-nvidia-confidential-computing/)
測試採 NVFP4 權重、FP8 KV 快取、八路張量平行,輸入與輸出長度分別為 32K、1K,並行請求數介於一至十六。環境為 Intel TDX 搭配 TensorRT LLM 1.3.0rc22。這些條件限定了百分比的解讀範圍,不能由此推算其他模型、短請求或高並行服務的成本。[測試配置](https://developer.nvidia.com/blog/enabling-private-high-performance-production-ai-inference-with-nvidia-confidential-computing/)
效能調整首先發生在 CPU 與 GPU 間的搬移。受保護的虛擬機記憶體無法讓 GPU 直接存取,資料須經加密中介緩衝區;原本常用的鎖頁記憶體因此失去部分非同步傳輸優勢。相關修補改為依機密運算狀態決定是否鎖頁,並加入非同步工作程序處理取樣資料回讀,降低主排程器遭複製作業阻塞的機會。[記憶體與回讀修補](https://github.com/NVIDIA/TensorRT-LLM/pull/11573)
另一項改動針對自動調校的量測基礎。CUDA event 在該保護模式下可能提供不穩定的計時訊號,影響核心實作的選擇;替代路徑透過小型 CUDA 核心讀取 GPU 的全域計時器,再由主機計算耗時。計時後端會依保護狀態選擇,也提供環境變數覆寫,方便工程師比較。[計時修補](https://github.com/NVIDIA/TensorRT-LLM/pull/11657)
對框架作者而言,這些實作提供了一個排查順序:先確認資料搬移是否堵住排程,再檢查量測工具是否讓調校選錯核心,最後比較跨卡通訊的等待成本。這是從修補內容推導的工程建議;單看 GPU 核心速度,可能漏掉保護模式改變的主機端行為,因此既有最佳化設定也需要重新驗證。
多卡通訊仍有限制:B200 的此類配置不支援 NVLS 多播,通訊演算法須配合拓撲與訊息大小調整。這份結果來自廠商測試,平均 token 延遲也無法回答首 token 或尾端延遲是否符合服務目標。部署評估應在相同模型、版本與負載下切換保護模式,另量測完整請求延遲;吞吐量接近只能支持效能判斷,不能代替安全驗證。[適用限制](https://developer.nvidia.com/blog/enabling-private-high-performance-production-ai-inference-with-nvidia-confidential-computing/)