AI 研究
LangChain 測試 Jev 代理評分器,五個固定案例呈現較低分數變異
LangChain 將五份天氣代理紀錄各重評一百次,觀察到 Jev 的分數變異與呼叫成本較低。測試僅有單一人工標註者,取樣設定與託管模型版本也限制了結果的解讀。
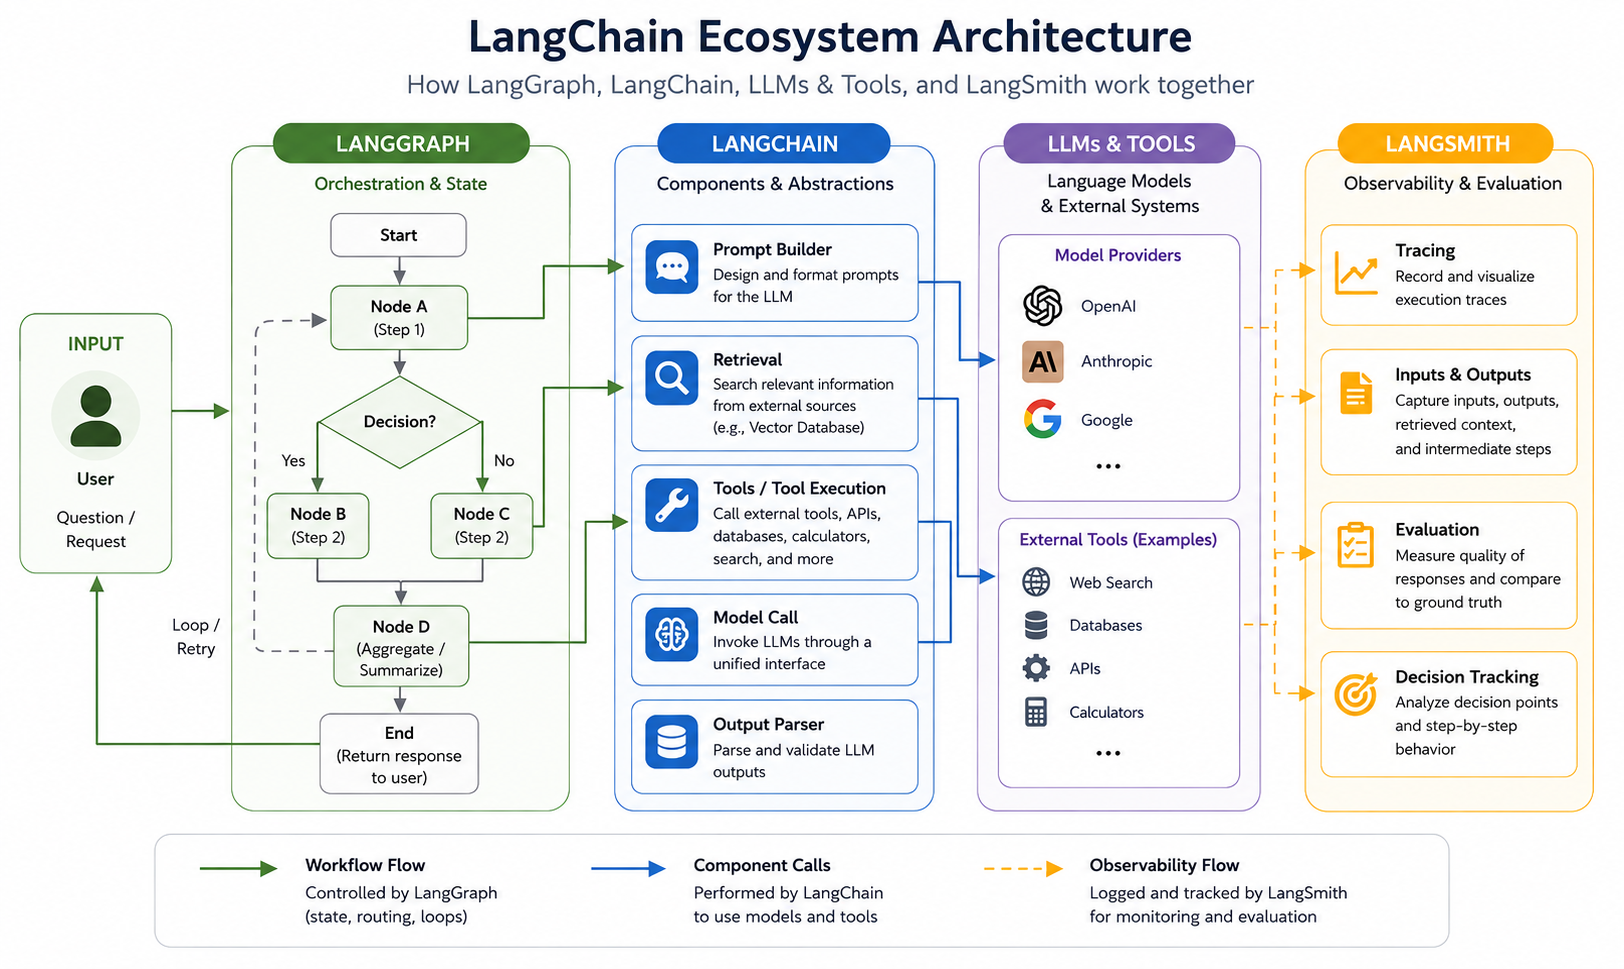
LangChain 於 9 月 20 日公布代理評分實驗,比較 TypeSafe AI 的 Jev 與三款語言模型裁判。研究重點是同一份執行紀錄反覆送評時,分數能否保持一致;這會影響團隊能否分辨程式退步與評分器本身的波動。[實驗公告](https://www.langchain.com/blog/jev-agent-evals-langsmith)
團隊以 Deep Agents 建立天氣代理,固定保存五個案例的回答、證據與工具呼叫,每個裁判各重評一百次。二元通過判斷用來比較單一人工標註者的答案,連續品質分數則用來量測變異。所謂五百次判斷,實際是五份固定輸出的重複評分,並非五百項不同任務。[實驗設計](https://github.com/danielgshea/jev-as-a-judge)
作者回報,Jev 的平均案例內品質分數變異數為 0.0000149;Sonnet 4.6、GPT-5.6 Luna 與 Terra 分別是其 92、433 及 913 倍。Jev 的二元判斷全部符合人工標籤,但其連續分數仍有波動,不能稱為完全確定性的裁判。平均每次呼叫耗時 0.44 秒、費用約 0.00035 美元,均限於這次負載。[結果與限制](https://www.langchain.com/blog/jev-agent-evals-langsmith)
Jev 的介面直接回傳選項、分數或是非機率,應用程式可組合多個小判斷,不必先解析自由文字。不過,機率與品質尺度必須分清:某條件有一半機率成立,不等於答案品質位於中間。TypeSafe 文件建議先拆開評分因素,再由程式加權,這也提供檢查評分規則的切入點。[型別化問題文件](https://docs.typesafe.ai/primitives)
可重現性仍有缺口。儲存庫公開凍結案例、人工標籤與分析入口,但語言模型未明設溫度、取樣種子等參數,沿用服務預設;實驗中繼資料也未揭露託管 Jev 的服務版本。因此,低變異與模型架構的因果關係尚未成立,固定判錯仍可能造成穩定的錯誤訊號。重新測試時,也需追蹤網路延遲與供應商版本變動。[重現說明](https://github.com/danielgshea/jev-as-a-judge)
對中文代理團隊而言,這項結果提供的是評測方法:先凍結執行軌跡,再分別量測正確性與重複性。導入前仍應加入繁體中文、模糊需求與失敗案例,並取得多位人工標註者共識;擴大任務覆蓋,比單純增加同一案例的重評次數更能檢驗泛化能力。